データは、情報化時代の人々の生活にとって貴重な財産です。膨大な情報源からデータが集まるため、近年、多くの組織がデータの統合とガバナンスに苦慮しています。そのため、各企業には、この問題を解決し、業績を向上させる包括的なソリューションが必要です。このブログでは、これらの課題に対応するための一般的なアプローチを紹介します。
データウェアハウス
まず、データウェアハウスの定義と主な特徴を見ていきましょう。
定義
データウェアハウスは、変換済みのデータを格納する中央リポジトリです。データウェアハウスに一度格納されたデータは変更できません。構造化、半構造化、非構造化の入力データなど、さまざまな種類のデータは、データウェアハウスに取り込まれる前にETLプロセスによって変換されます。データウェアハウスの主な機能は、過去のデータの分析とクエリの実行です。
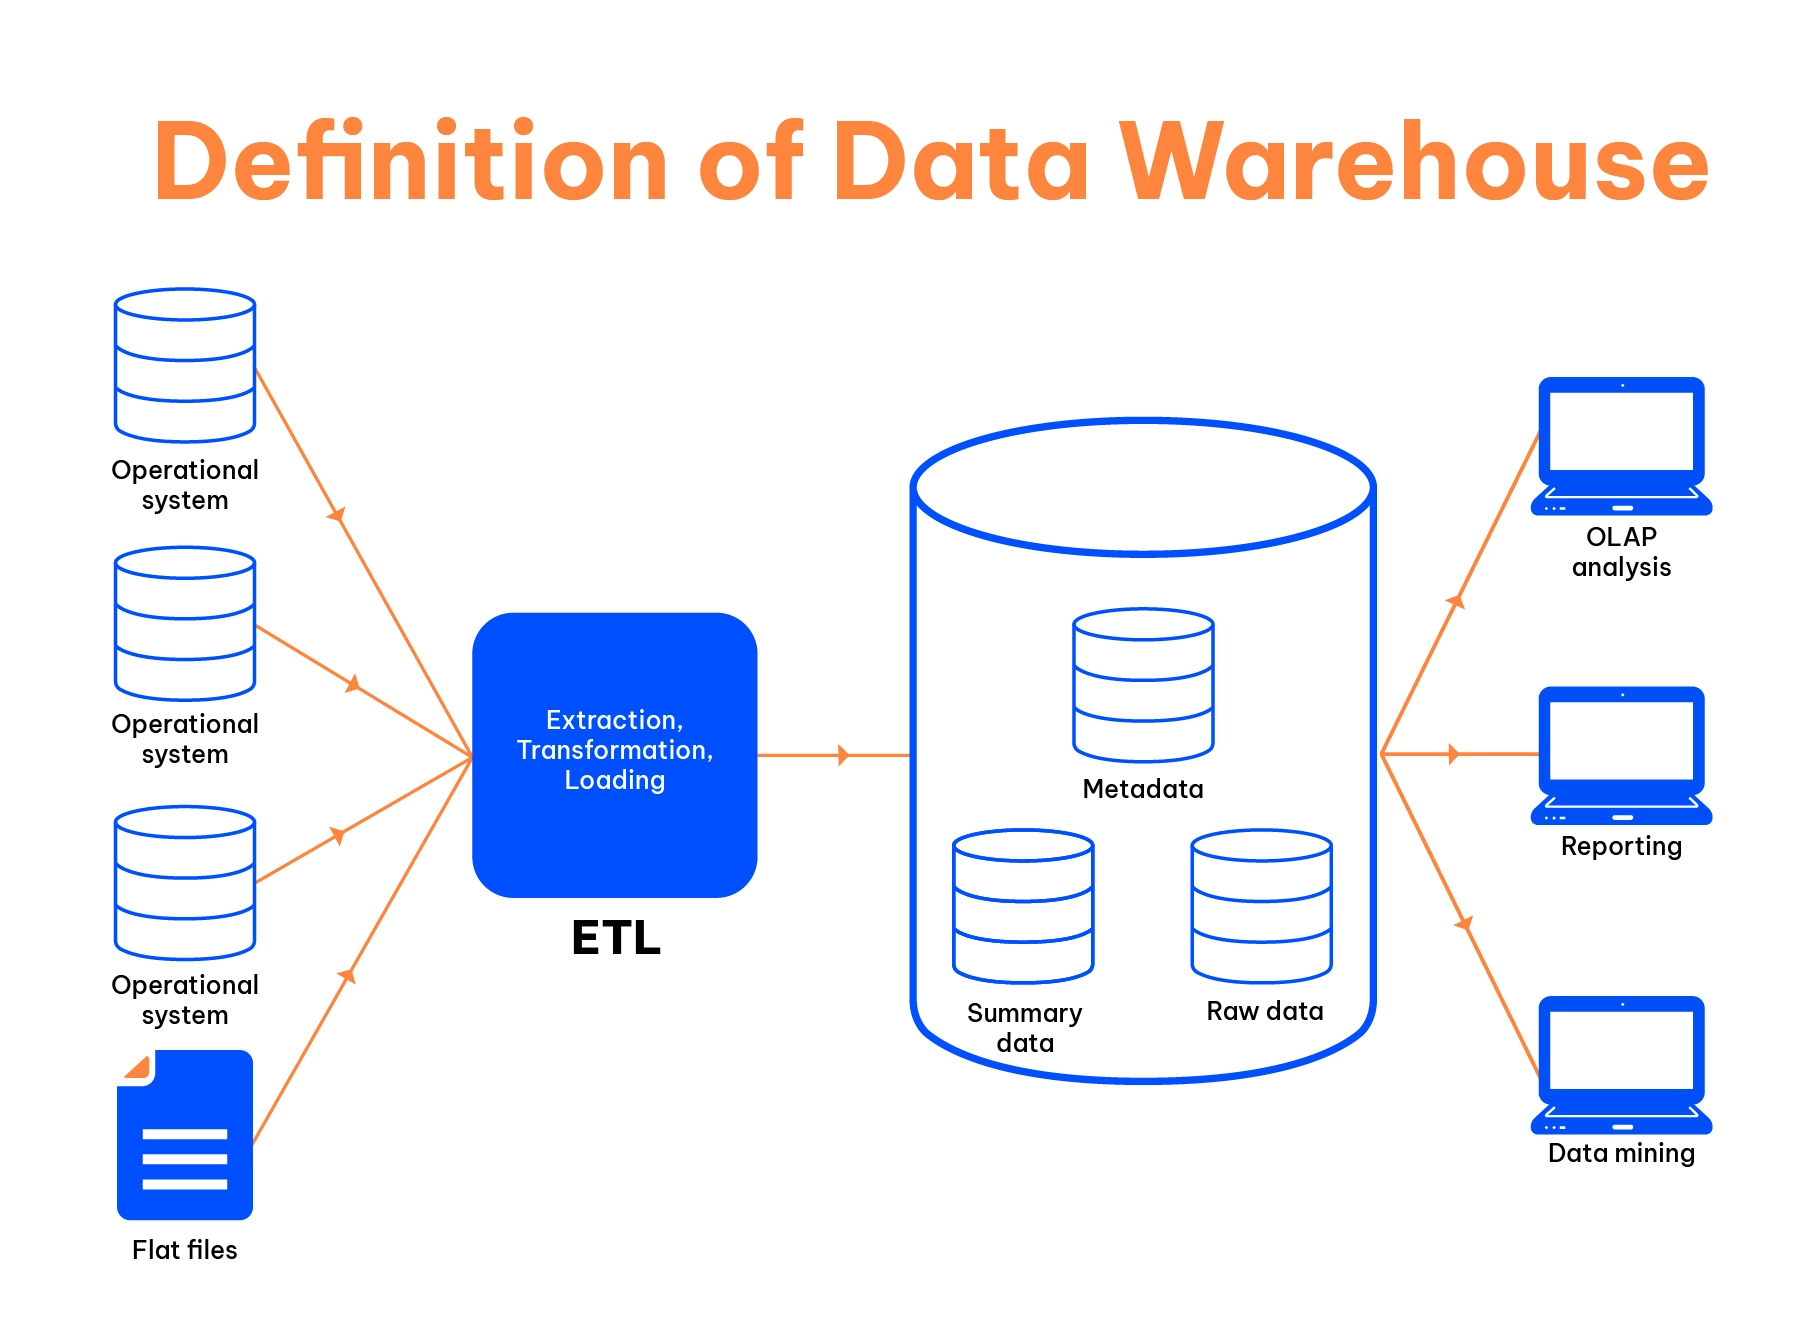
データウェアハウスの特徴
データウェアハウスは、意思決定を支援するデータ管理システムとされています。次の四つの明確な特徴があります。
サブジェクト指向
データウェアハウジングのプロセスは、組織の既存の業務ではなく、販売、流通、マーケティングなどの特定のテーマに対応するように設計されています。データをモデル化し、無関係な情報や重複する情報を排除することで、特定のテーマに関する意思決定に重点を置きます。
統合性
データウェアハウスを構築するために、メインフレーム、フラットファイル、リレーショナルデータベースなど、多数の情報源からのデータを統合します。このデータウェアハウスの統合により、異なるデータベースから得られる同種のデータすべてに標準形式を適用し、適切なデータ分析を支援します。重要なのは、命名規則、尺度、エンコーディング構造などの信頼性を確保することです。
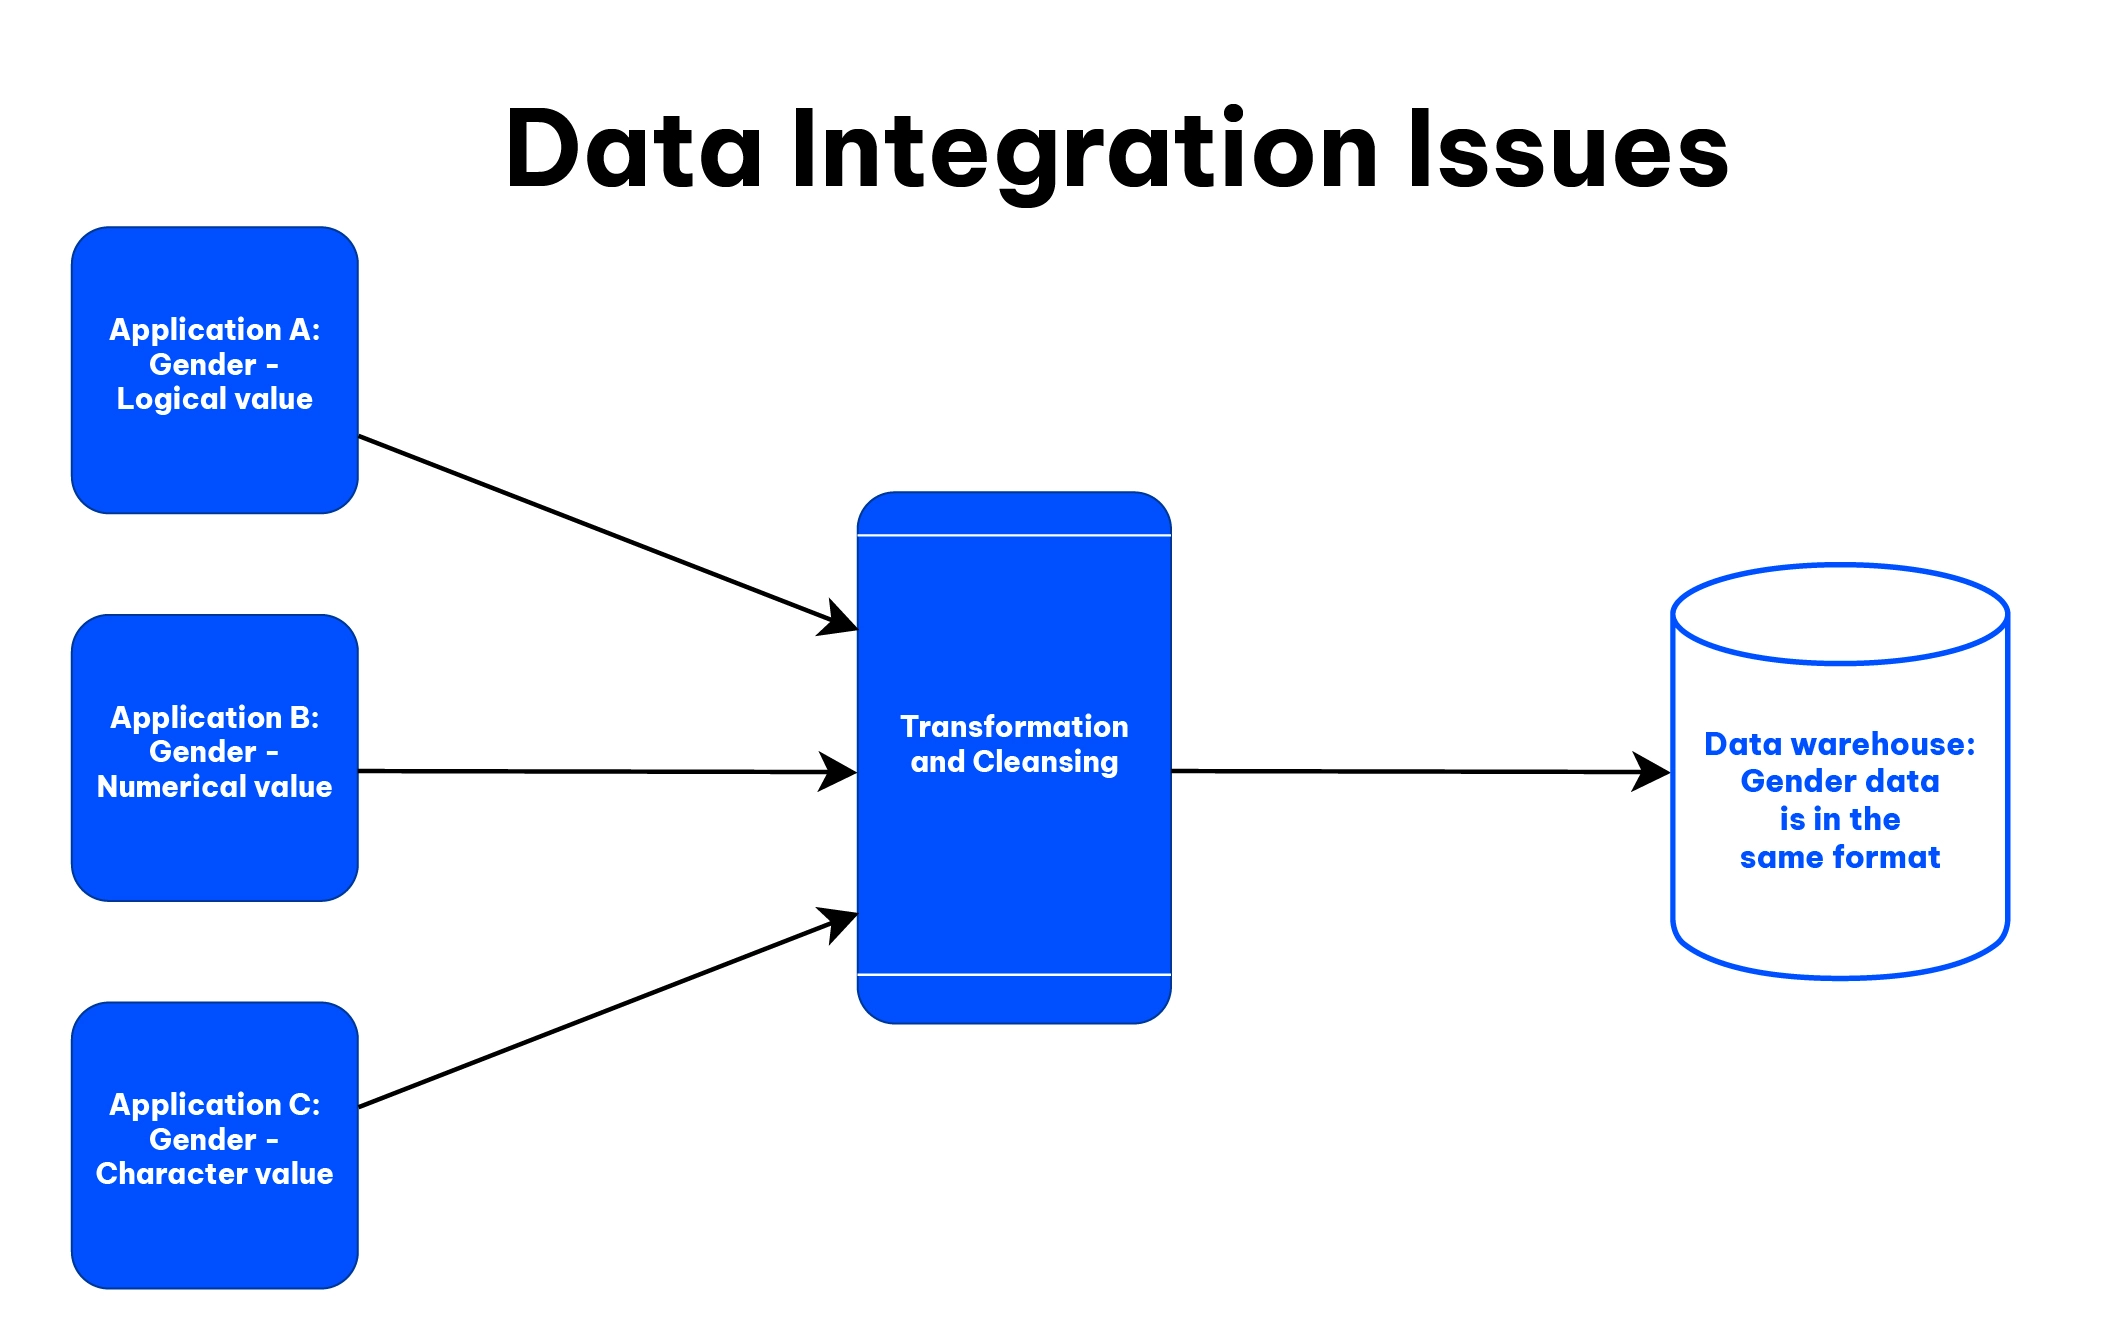
例えば、性別、日付、残高に関する情報を持つ、A、B、Cという三つの異なるアプリケーションがあるとします。しかし、上の図に示すように、それぞれのアプリケーションでは、性別データが異なる形式で保存されています。
- アプリケーションA:性別データは論理値です。
- アプリケーションB:性別データは数値です。
- アプリケーションC:性別データは文字値です。
処理とクレンジングの工程を経て、三つのアプリケーションの性別データは、データウェアハウス内で同じ形式に変換されます。
時系列性
時系列性は、データウェアハウスが一定期間内で一貫性を保つことを示す独自の特徴です。つまり、データウェアハウスには毎日、毎時間、またはその他の周期でデータがロードされ、その期間内では変化しません。この特徴により、日々の業務取引記録を保存し、最新の情報しか保持できない運用システムとデータウェアハウス(DW)が区別されます。
図1に示すように、運用システムは、データがデータウェアハウスにロードされる前の元のデータソースとされています。データウェアハウス内の過去のデータは、特定の期間にわたってクエリと分析の対象となります。一方、トランザクションシステムでは、古いデータは移動または削除されます。
例えば、ある女性の顧客が貴社の製品を購入したとします。彼女はオーストラリアのメルボルンに住んでいましたが、その後シドニーに移り、2008年から2013年まで暮らしました。現在は、2014年7月からフランスのパリに定住しています。
企業はデータウェアハウスを使用して顧客の過去の住所をすべて確認できますが、トランザクションシステムでは現在の住所のみが更新されます。
不揮発性
データウェアハウスに保管されたデータは永続的なため、新しいデータが入力されても消去や削除はされません。データはあらかじめ決められたタイミングで更新され、読み取り専用であるため、過去のデータの確認や分析に役立ちます。
トランザクション処理、復旧、同時実行制御の手法は必要ありません。データウェアハウス環境では、業務アプリケーションで実行される削除、更新、挿入などの機能は除外されます。代わりに、次の2種類のデータ操作があります。
- データのロード
- データへのアクセス
データウェアハウスのアーキテクチャ
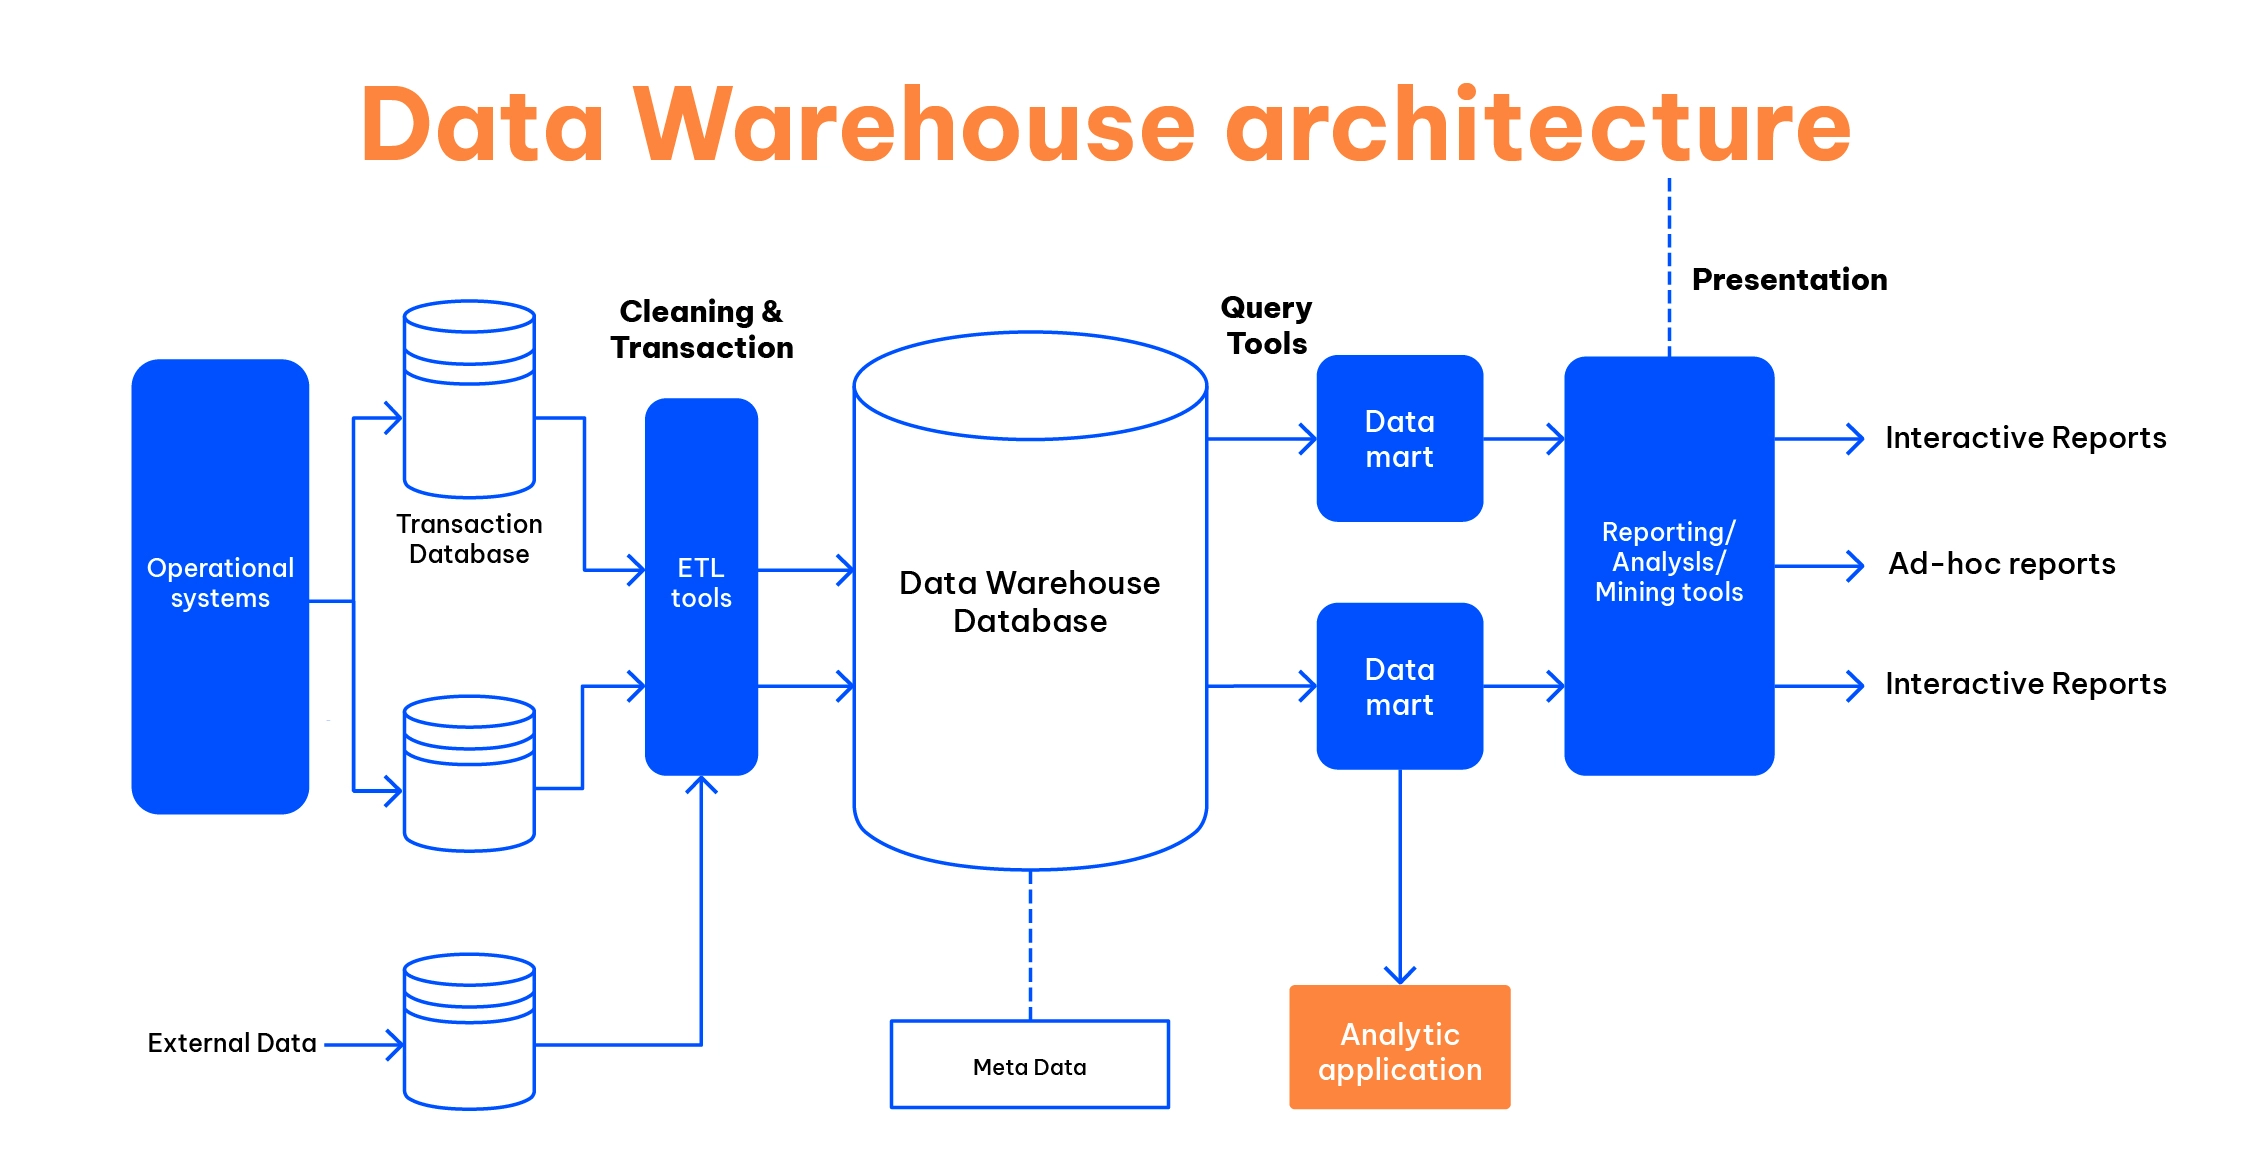
現代のデータウェアハウスには、データを適切に保存、クレンジング、整理するための設計および構成要素として「データウェアハウスアーキテクチャ」が必要です。データウェアハウスアーキテクチャの主な目的は、カスタマイズされたクエリ、ビジネス分析、意思決定を支援するために、多様なデータソースから企業情報を統合するうえで最も効果的なアプローチを決定することです。
以下のデータウェアハウスモデルによると、このプロセスには次の5つの主要な構成要素があります。
- データウェアハウスアクセスツール(ETLツール)
- 中央データベース(データウェアハウスデータベース)
- メタデータ
- クエリツール
- データウェアハウスバス
ただし、構成要素は企業の要件や状況によって異なる場合があります。
データウェアハウスアクセスツール(ETLツール)
ETLツールは、元のソースからデータを抽出し、データウェアハウスに取り込む前に標準形式に変換します。
これらのETLツールが行う作業は次のとおりです。
- 業務データベースのデータをデータウェアハウスにロードする前に、不要なデータを除去する
- 集計値および抽出されたデータの計算を行う
- 欠損データにデフォルト値を設定する
- 複数の元のソースから取得したデータの重複を排除する
- 異なるソースから取得したデータの名称と定義を特定し、共通の名称と定義に置き換えます。
中央データベース
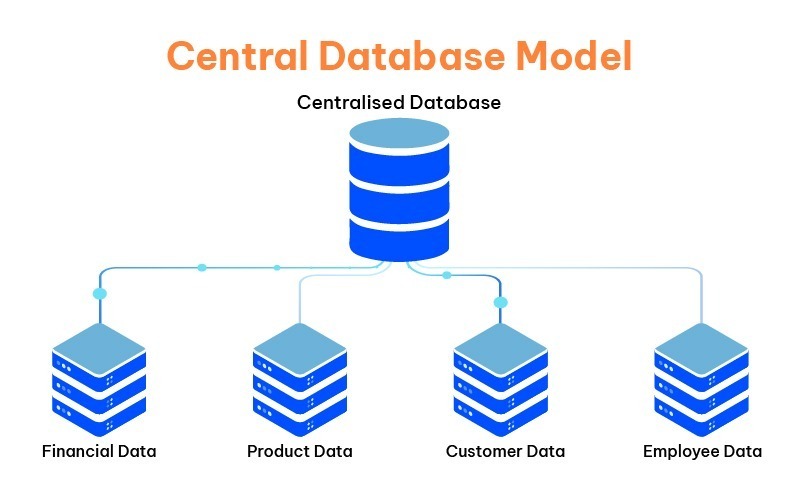
中央データベースとは、組織のすべてのデータを保管し、分析やレポート作成に利用できるようにするデータベースです。重要なのは、データウェアハウスに情報を保存するうえで適切なデータベースの種類を、企業が決定しなければならないという点です。
近年、多くの企業が強固な基盤を構築するために、リレーショナルデータベースを中央データベースとして選択しています。今日では、リレーショナル技術の進歩により、リレーショナルデータベースはビジネスインテリジェンス、データ統合、データウェアハウジングでますます活用されています。
ビジネスインテリジェンスにおけるリレーショナルデータベースを支援するため、技術アーキテクチャの多くの部分で、さまざまな代替技術がリレーショナルデータベースに取って代わりつつあります。 広く普及している技術には、次のようなものがあります:
- OLAPデータベース
- 超並列処理(MPP)データベース
- データ仮想化
- データベース内分析
- インメモリ分析
- クラウドベースのBI、DW、またはデータ統合
- NoSQLデータベース
メタデータ
メタデータは、企業内で作成、変換、保存、アクセス、活用される「データに関するデータ」です。メタデータは、データウェアハウス内でデータがどのように変更・処理されるかを決定します。また、データの出所、用途、値、特性も明らかにします。
メタデータを効果的に扱うには、データが何を表しているのか、どこから抽出されたのか、どのように変換されたのかなどを理解することが重要です。これにより、ビジネス分析に必要な、一貫性と完全性を備えた、検証済みでクリーンかつ最新のデータを提供できます。
メタデータが生データを価値ある知識に変換する例:
生データ: 2501 TK019 09.08.22
- モデル番号: 2501
- 営業担当者ID: TK019
- 日付: 09/08/2022
メタデータには、技術メタデータとビジネスメタデータの2種類があります。
技術データ: ソフトウェアツールによって処理されるデータで、主にデータウェアハウスの設計者や管理者が使用します。例として、次のようなものがあります:
- ETLツールは、フィールド、ソースとターゲット間のマッピング、変換、ワークフローを指定します。
- データベースは、列(形式、サイズなど)、テーブル、インデックスを精査します。
- BIツールはフィールドを解釈し、レポートとして出力します。
ビジネスデータ: エンドユーザーがデータウェアハウスに保存された特定のデータセットをより簡単に理解できるようにするデータです。例えば、週間売上、在庫回転率、予算差異に関するレポートのビジネス上の文脈は、ビジネスデータに該当します。
クエリツール
クエリツールを使用すると、組織はデータウェアハウスシステムとやり取りできます
クエリツールには、次の4種類があります:
- クエリおよびレポートツール
- アプリケーション開発ツール
- データマイニングツール
- OLAPツール
データウェアハウスバス
データウェアハウスバスは、データウェアハウス内のデータフローを決定します。このフローは、流入、流出、上向きフロー、下向きフロー、メタフローで構成されます。データバスを構築する際は、データマート間で共有されるディメンションとファクトを十分に考慮する必要があります。
データマート
データマートは、営業、マーケティング、財務、人事など、特定の業務領域に焦点を当てたデータウェアハウスのサブセットです。通常は単一の部門が管理し、組織内の特定のチームが使用します。 データウェアハウスとは異なり、データマートは規模が小さく柔軟性が高く、より少ない入力元からデータを取得します。
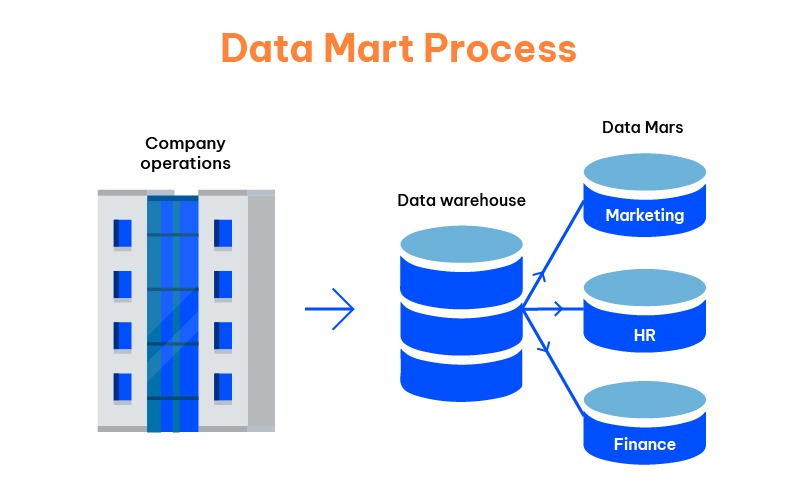
データマートの実装には、五つの基本的なステップがあります。
ステップ1:設計
- 技術面およびビジネス面の要件を収集し、データソースを特定します。
- 適切なデータのサブセットを選択します。
- データマートの論理構造と物理構造を確立します。
ステップ2:構築
前の段階で策定した実際のデータベースをデプロイします。
例えば、テーブル、インデックス、ビューなど、データベーススキーマで使用されるオブジェクトが含まれます。
ステップ3:データの格納
- ターゲットデータへのマッピングの作成
- データソースからのデータの抽出
- データのクレンジングと変換
- データマートへのデータのロード
- メタデータの構築と保管
ステップ4:アクセス
アクセスのステップでは、次の作業を実行する必要があります。
- データベースの構造とオブジェクト名をビジネス用語に変換するメタレイヤーを導入します -> 技術的な専門知識のないユーザーがデータマートで容易に作業できるよう支援します。
- データベース構造を構築し、発展させます。
- 必要に応じてAPIとインターフェースを構築します。
ステップ5:管理
データマートの実装プロセスは、このステップで完了します。このステップには、次のような管理業務が含まれます。
- 継続的なユーザーアクセスの管理
- システムパフォーマンスの最適化と調整
- データマートへの新しいデータの逐次ロードと管理
- 復旧方法を準備し、システム障害が発生した場合のシステムの可用性を保証します。
データウェアハウスのレポーティング層
エンドユーザーは、データウェアハウスのレポーティング層を通じて、BIインターフェースやデータベースアーキテクチャにアクセスできます。データウェアハウスのレポーティング層は、データの可視化、レポートの作成、抽出のためのダッシュボードとして機能します。
データウェアハウスは、統一された形式のデータのみを取得します。そのため、複数のソースからの生データを適切なデータ形式に変換するには、ETLツールのような最適なツールを使用することが不可欠です。ETLツールは、高いデータ品質を保証しながら、大量のデータを抽出、変換し、データウェアハウスにロードする速度と効率を高めることができます。 円滑なデジタルトランスフォーメーションで未来に備えましょう 業務を中断させないモダナイゼーションサービスで、ビジネスの成長を加速しましょう。既存インフラの価値を最大化し、プロセスを効率化して、コストを削減します。
データウェアハウスにおけるETL(抽出、変換、ロード)
では、データウェアハウスにおけるETLプロセスの役割は何でしょうか。プロセスを合理化し、効率を高めるために、どのように活用されるのでしょうか。
定義
ETLはExtract、Transform、Loadの略で、抽出、変換、ロードを意味し、今後の作業に向けて異なるソースのデータを統一されたビューに統合する三つのステップを指します。
Google Cloudによると、ETLとは「企業が、構造化データと非構造化データを含め、世界中のあらゆる場所でさまざまなチームが管理するすべてのデータを取り込み、ビジネス目的に役立つ状態にするまでの一連のプロセス」です。
簡単に考えるには、ETLを衣料品店、商品をデータとしてイメージするとよいでしょう。最初のステップは、さまざまな衣類ラックから服を取り出すことです。 その後、お客様の要望に応じて、花柄または水玉模様の包装紙で衣類を包みます。最後に、包装した衣類をお客様の袋に入れるのが皆さんの役割です。
ETLはどのように機能するのでしょうか?
もちろん、ETLにはデータとその内部処理に関する深い理解が必要なため、衣料品店のように単純に機能するわけではありません。以下で説明するように、ETLはデータを統合し、データウェアハウスにロードする役割を担います。ETLは次の3つの段階で構成されます。

抽出
ETLプロセスの最初のステップは、データの抽出です。この段階の主な機能は、次のようなさまざまなソースからデータを取得することです。
- レガシーデータベースとストレージ。
- 顧客関係管理システム(CRM)。
- 企業資源計画システム。
- モノのインターネット(IoT)のセンサーデータ。
- 営業およびマーケティングのアプリケーション。
- 顧客の取引データ。
- ソーシャルメディアおよびその他のオンラインソース。
データソースには、構造化データ(そのまま抽出できるデータ)、非構造化データ(抽出前に空白や顔文字の削除などの変換が必要なデータ)といったさまざまな形式があり、既存のデータベース、CRMシステム、クラウド、データウェアハウスから取得することもあります。
データを抽出する3つの方法:
- 通知ベースのデータ抽出:データを取得する最も簡単な方法の1つです。具体的には、一部のデータソースはデータが変更されるたびにETLシステムに通知を送ります。ETLの抽出段階では、新しいデータを更新するだけで済みます。
- 全件抽出:一部のソースはデータの変更を検出できるため、ETLはソースからすべてのデータを抽出する必要があります。この抽出方法では、前回抽出したデータのコピーを保持し、新しいコピーと比較できるようにする必要があります。データ転送量が多いため、全件抽出は小規模なテーブルに使用することが推奨されます。
- 部分抽出:通知ベースのデータ抽出とは異なり、一部のソースはデータの変更を通知しませんが、どのデータが変更されたかを記録しています。ETLシステムは定期的にソースを確認して変更の有無を特定し、変更されたデータを段階的に抽出します。この抽出段階の欠点は、ETLシステムがソースデータから削除されたレコードを識別できないことです。
変換
多くの場合、データは元の形式のままではデータウェアハウスに送ることができません。そのため、生データの処理には次のような複数のサブステップがあります。
- クレンジング:無関係なデータを削除し、不整合な値や欠損値を修正します。
- 標準化:異なる形式のデータを共通の形式に変換します。
- 重複排除:冗長なデータや繰り返し存在するデータを削除します。
- 検証:データの正確性を検証します。このステップでは、ETLシステムが異常なデータを特定して強調表示します。
- 並べ替え:データを種類に応じて整理します。
データ変換に特定のルールを必要としない場合、これは直接移動またはパススルーデータと呼ばれます。ただし、場合によっては、データの品質と可用性を確保するため、要件に基づいて複数の条件を適用する必要があります。
ロード
ETLプロセスの最後のステップは、ロードの段階です。この段階では、変換されたデータが新しい格納先であるデータウェアハウスにロードされます。格納先のデータ形式は、テキストファイル、Excelファイル、JSONファイル、XMLファイル、またはデータベースです。
変換済みデータをロードする方法には、次の2つがあります:
- フルロード:フルロードでは、変換済みのすべてのデータを単一のバッチとして、データウェアハウスまたはリポジトリ内の新しい一意のレコードにロードします。この方法は増分ロードよりもシンプルですが、時間がかかります。
- 増分ロード:このロード方式では、受信したデータと既存のデータを区別します。ETLシステムは、一意のデータが見つかった場合にのみ新しいレコードを追加します。増分ロードは管理しやすいものの、システム障害が発生するとデータの不整合が生じる可能性があります。適切なロード戦略を決めるには、個別の要件やデータの格納先の特性(速度、容量、データインターフェース)など、多くの要素を考慮する必要があります。
一般的な要件には、次のようなものがあります:
- データの上にビジネスインテリジェンスと分析のためのレイヤーを構築する。
- データを検索可能なデータベースとして活用する。
- 機械学習アルゴリズム用の学習モデルを作成する。
- データを基にアラートシステムを構築する。
ETLツールのさまざまな種類
ETLツールは、生データの抽出、標準形式への変換、データウェアハウスへの情報のロードまで、ETLプロセスを支援するソフトウェアアプリケーションです。これらのツールは、データ管理システムの運用を円滑にし、データ品質を確保するのに役立ちます。
Hub Spotによると、組織やベンダーが提供するインフラとサポートに基づき、ETLツールは4つの種類に分類されます:
Hub Spotによると、組織やベンダーが提供するインフラとサポートに基づき、ETLツールは4つの種類に分類されます。
企業向けソフトウェアのETLツール
営利企業は、企業向けソフトウェアのETL製品を開発・販売しています。これらの企業はETLツールの導入をいち早く推進してきたため、そのソリューションは業界全体でも特に信頼性が高く、成熟している傾向があります。これらのツールは、ETLパイプラインを設計・実行するためのグラフィカルユーザーインターフェース(GUI)を提供します。また、リレーショナルデータベースや、JSON、XMLなどの非リレーショナルデータベース、イベントストリーミングソースなどにも対応しています。
企業向けソフトウェアのETLツールには、次のようなものがあります:
- Informatica PowerCenter.
- IBM InfoSphere DataStage.
- Oracle Data Integrator (ODI).
- Microsoft SQL Server Integration Services (SSIS).
- Ab Initio.
- SAP Data Services.
- SAS Data Manager.
オープンソースのETLツール
オープンソース運動の成長は、オープンソースのETLツールの機能や速度を向上させ、その進化を促しています。多くのオープンソースETLツールは無料で提供されており、付属のGUIによって実用的に利用できます。これらは、データ共有プロセスの設計や情報フローの管理に使用されます。
この種のETLツールには、利点と欠点の両方があります。オープンソースソリューションの利点は、ソースコードにアクセスできるため、組織がツールのインフラを調べ、機能を拡張できることです。一方、通常は営利企業によるサポートがないため、一貫性に欠けるという欠点があります。
オープンソースのETLツールには、次のようなものがあります:
- Talend Open Studio.
- Pentaho Data Integration (PDI).
- Hadoop.
クラウドベースのETLツール
Amazon AWS、Google Cloud Platform、Microsoft Azureなど、多くのクラウドサービスプロバイダー(CSP)が、自社のインフラ上でETLツールを開発してきました。 これは、クラウドコンピューティングとサービスとしての統合プラットフォームの普及によって生まれました。
オープンソースのETLツールと同様に、クラウドベースのETLツールにも長所と短所があります。長所としては、潜在力、効率性、伸縮性が挙げられます。コンピューティングリソースは、その時点のデータ処理のニーズに合わせて拡張されます。また、企業が同じクラウドサービスプロバイダーにデータを保管すれば、パイプラインをさらに最適化できます。
一方、クラウドベースのETLツールの短所は、独自仕様への依存度が非常に高く、特定のクラウドベンダーのプラットフォームでしか利用できないことです。組織は、異なるクラウドストレージのデータを利用して、自社のデータセンターに移すことができません。
クラウドベースのETLツールの例は次のとおりです。
- AWS EMR.
- AWS Glue.
- Azure Data Factory.
- Google Cloud Dataflow.
カスタムETLツール
多くの企業は、汎用のプログラミング言語を使用して独自のETLソリューションを開発しています。この方法は柔軟性が非常に高く、組織のニーズやワークフローに応じた適切なソリューションを作成できます。一方、このツールの短所は、導入と運用に最も多くの労力と費用がかかることです。
独自のETLツールの構築によく使われるプログラミング言語:
- SQL.
- Python.
- Java.
これら4種類のETLツールについてさらに詳しく知りたい方は、こちらの詳細な分析をご覧ください!
結論
データウェアハウスは、統一された形式でデータを保存する場所です。ただし、多くのソースからデータを抽出し、変換したうえで、最終的にデータウェアハウスに読み込むには、ETLプロセスが必要です。ビッグデータの発展に伴い、あらゆる業界でETLの重要性が高まっています。
ビジネス上の取り組みや必須課題に対する高い要求により、ETL環境はますます大きく変化しています。Deloitteによると、今後のETLはツールよりもデータストリームに重点を置くようになります。組織には、リアルタイムの遅延、スキーマの変化、ソース中心の考え方、継続的な統合を考慮することが推奨されます。ETLはデータの統合、ガバナンス、品質、セキュリティのための究極のソリューションとなっているため、今後、その活用はさらに広がると見込まれます。 AIによる業務効率化で実現できる成果を想像してみてください 精度の高いAI主導のワークフローで業務を変革しましょう。ミスの削減からスピードの向上まで、オペレーショナルエクセレンスを実現し、持続可能な成長を推進します。
データをさらに役立てるための方法
データパイプラインの全段階における実務経験を生かしたGEMの包括的なデータサービスは、データをシームレスに統合し、重要なビジネス上の意思決定にすぐに活用できる状態を実現します。
GEMは、この重要な資産から得られる価値を高めるお手伝いをします。ぜひご相談ください!