自然言語処理(NLP)は、企業によるデータの処理・分析方法を変革し、より高度な戦略と自動化の向上を推進してきました。本記事では、難易度別に分類した35のNLPプロジェクトを紹介し、意思決定者が自社に適した機会を見つけるための包括的なガイドを提供します。初級から上級まで、これらのプロジェクトは、複雑なビジネス課題の解決におけるNLPの可能性を示しています。
引き続き、NLPの取り組みを効果的に実施するための実践的な戦略をご覧ください。
企業にとっての自然言語処理の力
人工知能の専門分野である自然言語処理(NLP)は、コンピューターと人間の言語の相互作用に焦点を当てています。顧客のフィードバック、メール、ソーシャルメディアのコンテンツなどの非構造化データを、構造化されたインサイトに変換することで、組織は行動につながる成果を導き出せます。この能力により、NLPは業務の近代化と競争優位性の確立を推進する戦略的資産として位置づけられています。
NLPがビジネスにもたらす主な効果
世界のNLP市場規模は2028年までに681億ドルに成長すると推定されており(出典:MarketsandMarkets)、その用途は医療、金融、小売などの業界に広がっています。
NLPをビジネス戦略に組み込むことで、複数の領域で測定可能なメリットが生まれています。
業務ワークフローの効率化
文書の分類、テキスト分析、感情評価などの手作業には、従来、多くの時間とリソースが費やされてきました。NLPやその他の先進技術を導入すると、これらの作業を高い精度で自動化でき、チームは成果への影響が大きい業務に集中できます。これにより、ワークフローが加速するだけでなく、特に金融、医療、小売などの業界でリソース配分も最適化されます。
顧客エンゲージメントの向上
世界は、顧客とのつながりをより深めるため、ハイパーパーソナライゼーションへと向かっています。バーチャルアシスタントやチャットボットなどのNLPを活用したツールは、顧客とのやり取りを変革しています。これらのソリューションは、あらかじめ用意された応答にとどまらず、文脈を理解し、ユーザーの心に響く動的な会話を提供します。つまり、顧客の次の行動を予測して、期待を超える対応を実現するのです。企業にとって、これはあらゆる接点で信頼を育み、満足度を高め、ロイヤルティを築くこと、言い換えればオムニチャネル体験を意味します。
戦略的インサイトの抽出
ビッグデータは有用ですが、それに伴い、組織には顧客のフィードバックから市場分析レポートまで、膨大な非構造化データが押し寄せることが少なくありません。NLPはこれらの入力を解読し、意思決定の指針となる傾向、好み、行動につながるインサイトを明らかにします。データ分析にNLPを活用できる企業は、変化する市場の需要により的確に対応でき、それが業界をリードする切り札となります。
世界の利用者へのアクセシビリティ拡大
ビジネスのグローバル化には、言語や文化の隔たりを埋めるソリューションが求められます。リアルタイム翻訳や音声認識など、NLPを活用したツールは、地域を越えた円滑なコミュニケーションへの道を開きます。これにより、包摂性が高まり、コラボレーションが強化され、未開拓市場で新たな機会が生まれます。
変化するビジネスニーズへの対応
組織の発展に伴い、データエコシステムはますます複雑になります。レガシーシステムでデータ処理の問題が生じた場合、NLPシステムは増加するデータ量と多様なデータ形式を最も効率的に管理できるように設計されており、長期的な成長を支える安定性と柔軟性を提供します。
注目の自然言語処理(NLP)プロジェクト35選
35のNLPプロジェクトを網羅したこの一覧は、基礎概念から現実の課題に対応する最先端のイノベーションまで、自然言語処理のさまざまな用途を探る機会を提供します。
初級者向けNLPプロジェクト
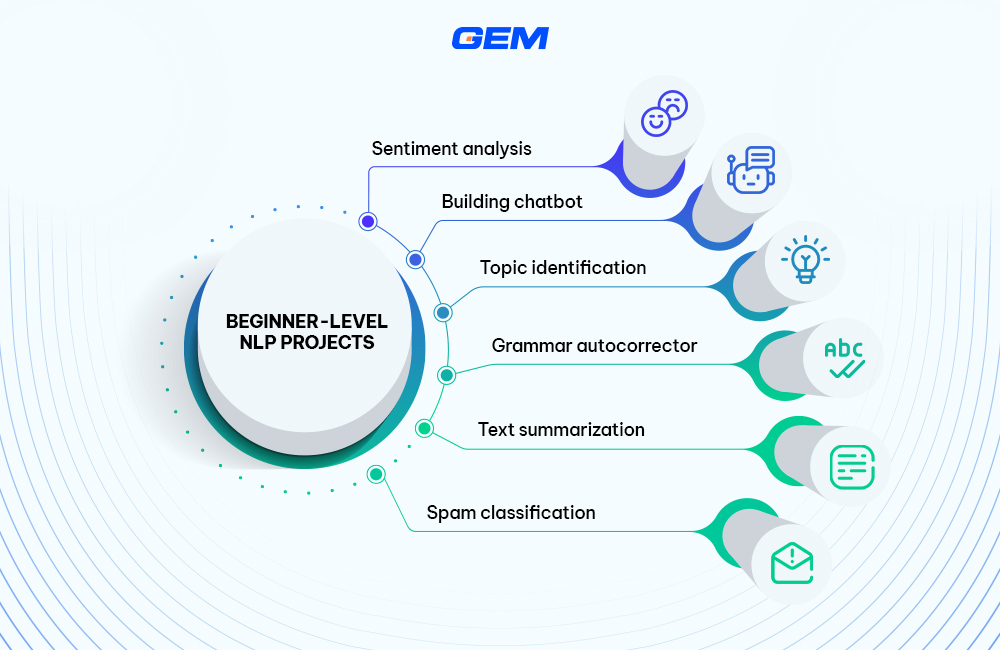
これらのプロジェクトはNLPの初心者向けに設計されており、シンプルな実装を通じて基本的な手法や概念を紹介し、確かな基礎を築きます。
1 – 顧客の意見を読み解く感情分析
企業は感情分析を活用して顧客のフィードバックを評価し、世間の受け止め方に見られるパターンを特定します。このアプローチでは、自然言語処理を用いてフィードバックを肯定的、中立的、否定的といったカテゴリーに分類し、意思決定に役立つインサイトを提供します。高度な手法を通じて、組織は不満や満足といった感情の微妙な違いも探り、顧客行動をより深く理解できます。
プロセス
プロセスは、テキストデータセット内の傾向を明らかにする探索的データ分析(EDA)から始まります。前処理の段階では、無関係な情報を取り除いてデータをクリーニングし、テキストを正規化し、関連するキーワードやフレーズに焦点を当てます。準備が整うと、アルゴリズムがデータを分析して感情を分類し、測定可能なインサイトを提供します。
主要な手法
- 辞書ベースの手法:VADERなどのツールは、事前に定義された単語辞書とスコアを使用して感情を分析します。
- 機械学習モデル:ロジスティック回帰やナイーブベイズなどのアルゴリズムは、データのパターンを学習することで、より正確な分類を行います。
- TF-IDF(単語頻度・逆文書頻度):データセット内での単語の重要度を測定し、感情分類に影響を与える重要な語句を特定する手法です。
- マルコフ連鎖と特徴量エンジニアリング:テキストの並びや単語間の関係をモデル化することで、感情予測の精度を高める手法です。
活用分野
- Eコマース:プラットフォームは商品レビューを分析し、共通するテーマの発見、在庫の調整、パーソナライズされたおすすめの提供に役立てます。
- マーケティングキャンペーン:ソーシャルメディア上の感情をリアルタイムで分析することで、企業はキャンペーンの成果を追跡し、それに応じて戦略を調整できます。
- 顧客体験:顧客からのフィードバックを監視することで、組織は繰り返し発生する問題に対処し、満足度の指標を改善できます。
推奨データセット
IMDb ReviewsやTwitter Sentiment Analysisなどのデータセットは、感情分析の手法をテストし、実際の場面に適用するための実践的な例を提供します。
2 – NLTKを使ったチャットボットの構築
チャットボットは、ユーザーの問い合わせに応じて自動で回答し、反復作業を削減します。このプロジェクトでは、テキストの前処理、入力の分類、論理的な回答の生成方法を示します。これらのシステムは日常的な問い合わせに対応しつつ、より複雑なタスクを体系的なエスカレーションプロセスによって管理します。
プロセス
チャットボットの開発プロセスは、生のテキストをクリーニングし、トークン化し、正規化する重要な段階であるテキストの前処理から始まります。見出し語化や品詞(POS)タグ付けなどの手法によって、テキストデータを分類に適した状態に整えます。開発者はPythonのNLTKライブラリを使用して、ユーザーの入力を分類し、適切な応答を生成するようチャットボットを学習させます。
主要な手法
- Bag-of-Wordsモデル:テキスト表現の基本的なアプローチであり、チャットボットのデータセットにおける単語の出現頻度のパターンを特定するために使用されます。
- ナイーブベイズ分類器:テキスト分類タスクで広く使用されるモデルで、チャットボットがユーザーのメッセージの意図を判断するのに役立ちます。
- 高度なモデル:より柔軟なチャットボットを実現するには、文脈を考慮した応答を生成するSequence-to-Sequence(Seq2Seq)モデルや、GPTのようなTransformerベースのアーキテクチャを検討してください。
活用分野
- カスタマーサポート:繰り返し寄せられる問い合わせへの対応を自動化し、待ち時間を短縮してユーザー体験を向上させます。
- Eコマース:ユーザーの商品選びを案内し、おすすめを提示し、注文の追跡を支援します。
- 医療:患者の診療予約や症状の確認を支援し、一次対応を提供します。
推奨データセット
Cornell Movie-Dialogs Corpusなどのオープンソースのデータセットや顧客との会話ログを使用して、チャットボットの学習とテストを行ってください。
3 – データラベリングのためのトピック識別
トピック識別は、非構造化データを分析して主要なテーマを抽出し、コンテンツを整理します。このアプローチは、顧客レビューや研究文書などの大規模なデータセットの管理に特に役立ちます。類似する情報をグループ化することで、組織は関連する知見にアクセスしやすくなり、データに基づく意思決定を改善できます。
プロセス
トピック識別では、テキストデータをクリーニングし、ベクトル化する前処理を行います。Count VectorizerやTF-IDFなどのアルゴリズムは、テキストを機械学習に適した数値形式に変換します。その後、潜在的ディリクレ配分法(LDA)やK-Meansクラスタリングなどのモデルを適用し、関連するトピックごとに文書をグループ化します。
主要な手法
- TF-IDFとCount Vectorizer:分析のためにテキストデータを数値表現に変換します。
- クラスタリングアルゴリズム:K-MeansクラスタリングやLDAなどの教師なし学習手法を使用し、類似性に基づいて文書をグループ化します。
- データクリーニングのための正規表現:テキスト入力を簡素化して標準化し、モデルの精度を向上させます。
活用分野
- 顧客フィードバック:レビューを商品の品質、価格、サービス提供などのテーマに分類し、改善の優先順位を決めます。
- 市場調査:競合他社のレポートや業界ニュースを分析し、新たなトレンドを特定します。
- コンテンツ管理:大量の文書を保管するリポジトリを整理し、検索や分析を容易にします。
推奨データセット
20 Newsgroupsデータセットは、トピックモデリングのプロジェクトで広く使用されているリソースです。
非効率によってリソースが浪費されていませんか?一緒に解決しましょう!
GEMの最先端ソリューションで、ワークフローの効率化と業務の最適化を支援し、ビジネスが持続的な成功を収めるための基盤を整えます。
4 – テキストの品質を高める文法自動校正ツール
文法自動校正ツールは、テキストを分析して文法上の誤りを検出し、修正します。これらのシステムは、不整合を解消し、文の構造を整えることで、文章コンテンツの読みやすさを向上させます。洗練された正確な文章の作成を目指す専門職の方、学生、執筆者にとって有用なツールです。
プロセス
文法自動校正ツールの構築には、前処理、ルールベースのアプローチ、統計的なNLPモデルまたは事前学習済みのNLPモデルを使用します。spaCyやLanguageToolなどのライブラリは、強力なスペルチェック機能と文法校正機能を提供します。GPTやBERTなどの事前学習済みモデルをファインチューニングすることで、特定のユースケースにおける精度を向上させられます。
主要な手法
- スペルチェッカー:HunspellやPySpellCheckerなどのライブラリを使用して、スペルミスのある単語を特定します。
- ルールベースモデル:文法規則を適用して、文構造の誤りを特定します。
- 事前学習済みモデル:GPTやBERTをファインチューニングして、文法上の誤りを修正し、文体の改善案を提示します。
活用分野
- コンテンツ制作:ブログ、レポート、学術論文の文章の質を向上させます。
- リアルタイム校正:チャットアプリケーションやテキストエディターに自動修正機能を組み込みます。
- ビジネスコミュニケーション:メールやプレゼンテーションに誤りがないようにします。
推奨データセット
KaggleのC4 200M Grammar Error Correctionデータセットは、文法校正システムの構築に最適なリソースです。
5 – 効率的な情報理解のための自動テキスト要約
自動テキスト要約は、最も関連性の高い詳細に焦点を当て、長いコンテンツを簡潔な要約にまとめます。この手法は、ユーザーが大量の情報を効率的に処理できるようにし、文書全体を確認せずに重要なポイントを把握しやすくします。
プロセス
テキスト要約の手法は、次の2種類に分けられます。
- 抽出型要約:関連性に基づき、テキストから重要な文を直接選び出します。
- 抽象型要約:NLPモデルを使用してコンテンツを言い換え、凝縮することで要約を生成します。
Hugging Face Transformersなどのライブラリは、これらの手法の実装に特に効果的です。コサイン類似度などのアルゴリズムで文の重要度を順位付けし、GPTやT5などの事前学習済みモデルで、特定のユースケースに合わせて要約を細かく調整します。
主要な手法
- コサイン類似度:文書内の文の関連性を測定します。
- Hugging Face Transformers:抽出型と抽象型の両方の要約タスクに対応する事前学習済みモデルです。
- モデルのファインチューニング:分野固有のデータでモデルを学習させ、精度を向上させます。
活用分野
- 法律・金融サービス:長い契約書やレポートを要約し、重要なポイントを明確にします。
- ニュース集約:短時間で読める簡潔なニュース要約を生成します。
- 医療:患者の記録を要約し、診察中の迅速な意思決定を支援します。
推奨データセット
Amazon Fine Food ReviewsデータセットやCNN/DailyMailデータセットは、要約手法をテストするための優れた機会を提供します。
6 – 迷惑メール対策のためのスパム分類
スパム分類は、無関係または有害なメールを特定してフィルタリングし、重要なメッセージから分離します。このプロセスでは、分類アルゴリズムを適用してメールの内容を分析し、スパムのパターンを検出します。これにより、詐欺的なメッセージに接する機会を減らしながら、重要なコミュニケーションの優先順位をより適切に付けられます。
プロセス
スパム分類は、メールのデータセットを収集し、トークン化、ストップワードの除去、テキストのベクトル化によってデータを前処理することから始まります。ロジスティック回帰やLSTM(Long Short-Term Memory)ネットワークなどのアルゴリズムを学習させ、スパムメールに関連するパターンを特定します。
主要な手法
- テキストの前処理:メールの内容をトークン化してクリーニングし、モデルの性能を向上させます。
- TF-IDFと単語埋め込み:分析のためにテキストを数値的な特徴量に変換します。
- 敵対的学習:進化するスパムのパターンを認識し、敵対的な手口に対処できるようモデルを強化します。
活用分野
- メールサービスプロバイダー:スパムメールやフィッシングメールをフィルタリングし、受信トレイの品質を向上させます。
- 金融分野:顧客を狙った詐欺的なコミュニケーションを防ぎます。
- マーケティング:スパムのような販促メールを特定して削除し、ブランドの評判を守ります。
推奨データセット
Email Spam DatasetやEnron Email Datasetは、スパム分類アルゴリズムの学習とテストに最適なリソースを提供します。
詳しくはこちら:GEMのNLP・AIチャットボット開発サービスが、顧客とのやり取りを自動化し、ユーザーの意図を理解するインテリジェントなチャットボットをどのように構築するかをご覧ください。
初級レベルのNLPプロジェクト
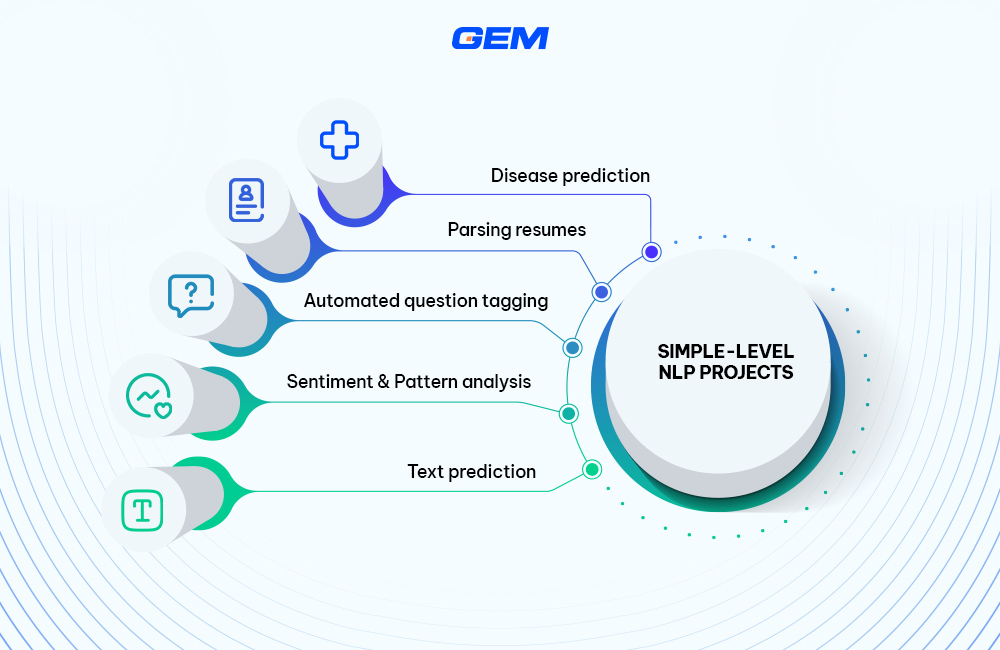
これらのプロジェクトは、少し構造化されたタスクに焦点を当て、学習者が複雑さを最小限に抑えながら実用的な問題を解決し、基本的なNLP手法を適用できるようにします。
1 – 予測テキストシステム
予測テキストシステムは、入力テキストを予測して補完するために、メッセージングアプリケーションで広く使用されています。このプロジェクトでは、基礎的および高度なNLP手法を使用して、系列内の次の単語やフレーズを予測する同様のシステムを構築します。
プロセス
このプロジェクトは、Pythonでn-gramモデルを理解して実装することから始まり、単語の系列を分析するための基盤を築きます。性能を向上させるために、RNN(再帰型ニューラルネットワーク)、LSTM(長短期記憶ネットワーク)、エンコーダー・デコーダーアーキテクチャなどのモデルを適用できます。前処理の手順には、テキストデータのクリーニングと、学習に向けた準備が含まれます。
主要な手法
- N-Gramモデル:単語のパターンと関係を分析して系列を予測します。
- 再帰型ニューラルネットワーク(RNNs):テキストデータの系列的な依存関係を捉えます。
- LSTMs:長期的な依存関係に対応し、テキスト予測における文脈理解を向上させます。
活用分野
- メッセージングプラットフォーム:予測入力を可能にし、ユーザー体験を向上させます。
- アクセシビリティツール:文の補完機能を提供し、障害のあるユーザーを支援します。
- スマートデバイス:仮想アシスタントが文脈に適した応答を生成できるようにします。
推奨データセット
Penn TreebankなどのデータセットやGutenbergなどのテキストコーパスを使用して、予測テキストモデルの学習とテストを行えます。
2 – テキスト前処理パイプライン
このプロジェクトでは、テキストデータをクリーニングし、その後の分析に向けて準備する基本的なテキスト前処理パイプラインを構築します。初心者が、生のテキストを機械学習モデルで効果的に処理できる構造化された形式に変換することの重要性を理解するのに役立ちます。
手順
- NLTKやspaCyなどのライブラリを使用し、小文字化、句読点の除去、ストップワードの除去、トークン化などの標準的な前処理から始めます。
- レンマ化やステミングを追加して単語を正規化し、パイプラインを拡張します。
- MatplotlibやSeabornなどのツールで単語の頻度分布を可視化し、データセット内のパターンを特定します。
活用分野
- データ準備:あらゆるNLPモデルの開発に不可欠な工程です。
- 単語頻度分析:感情分析やテキスト要約などのプロジェクトで、テキストデータの特性を理解するのに役立ちます。
- 言語学習ツール:教育目的で、文書内によく登場する単語を特定するのに役立ちます。
推奨データセット
ニュース記事や製品レビューなどの小規模なテキストデータセット、またはSMS Spam Collectionなどの公開データセットを使用します。
3 – キーワード抽出ツール
このプロジェクトでは、与えられたテキストから最も関連性の高いキーワードを抽出するシンプルなツールを作成します。NLPにおける特徴抽出やテキストのランキング手法を学ぶのに適しています。
手順
- TF-IDF(単語頻度・逆文書頻度)などの基本的な統計手法を実装し、キーワードを特定します。
- Scikit-learnやspaCyなどのPythonライブラリを使用してTF-IDFスコアを計算し、上位のキーワードを抽出します。
- ワードクラウドや棒グラフで抽出したキーワードを可視化し、ツールを改善します。I
活用分野
- SEOツール:コンテンツ最適化に向けた重点キーワードを特定します。
- 研究要約:学術論文や報告書の重要な用語を強調します。
- コンテンツのタグ付け:ブログや記事のタグ付け作業を自動化します。
推奨データセット
短い記事、ブログ投稿、またはBBC Newsデータセットなどの公開データセットを使用してツールをテストします。
テクノロジーの力でビジネスを変革
AI、クラウドソリューション、高度な分析を導入して業務のあり方を刷新し、競争をリードしましょう。将来の変化に対応できるビジネスを、ともに築いていきましょう。
4 – 基本的な感情分析システム
このプロジェクトでは、テキストに含まれる感情に基づいて、肯定的、否定的、中立のいずれかに分類するシンプルなツールの構築に重点を置きます。初心者に、テキスト分類の手法とテキストの極性という概念を紹介します。
手順
- 映画レビューやツイートなどのラベル付きデータセットを学習に使用します。
- テキストをクリーニングし、トークン化して前処理します。
- Scikit-learnを使用して、ロジスティック回帰やナイーブベイズなどの基本的な機械学習分類器を実装します。
- 正解率、適合率、再現率などの指標でモデルを評価します。
活用分野
- ソーシャルメディアのモニタリング:ツイートやコメントの感情を分析します。
- 顧客フィードバック:レビューやアンケートから顧客の意見を評価します。
- 製品分析:製品やサービスに対する世間の感情を把握します。
推奨データセット
IMDb Movie ReviewsデータセットやTwitter Sentiment Analysisデータセットなどを使用します。
5 – 小売業のインサイトを得るための購買パターン分析
このプロジェクトでは、購買パターンを分析して消費者行動を理解することに重点を置きます。マーケットバスケット分析は、頻繁に一緒に購入される製品間の関係を特定し、企業による商品配置や販促の最適化を支援します。
手順
AprioriやFp Growthなどのアルゴリズムを実装し、取引データセット内の品目間の関連性を発見します。前処理には、分析に向けた取引データのクリーニングと変換が含まれます。結果を解釈するために、単変量分析や二変量分析などの統計手法を適用します。
活用分野
- 小売店:売上を伸ばすために効果的な商品配置を設計します。
- 電子商取引:クロスセルやセット販売の戦略を最適化します。
- 在庫管理:関連製品の需要を予測します。
推奨データセット
KaggleやUCI Machine Learning Repositoryなどのプラットフォームの取引データセットを使用して、モデルを構築・検証します。
6 – 質問の自動タグ付けシステム
大量のユーザー生成コンテンツを管理するには、効率的な分類が必要です。このプロジェクトでは、質問に関連するタグを自動的に付与するシステムを作成し、コンテンツの整理と見つけやすさを向上させます。
手順
質問、回答、タグを含むStackSampleデータセットを使用してモデルを学習します。前処理の工程には、Pandasなどのツールを使用したテキストのクリーニングとトークン化が含まれます。 関連するタグを予測するために、マルチラベル分類手法を使用します。追加データが必要な場合は、BeautifulSoupなどのWebスクレイピングツールを使用して、Quoraなどのプラットフォームから情報を収集できます。
活用分野
- Q&Aプラットフォーム:ユーザー生成コンテンツの整理を改善します。
- カスタマーサポートシステム:顧客からの問い合わせを分類し、効率的に対応します。
- コンテンツライブラリ:大規模データセットのタグ付け作業を自動化します。
推奨データセット
StackSampleデータセットに加え、Webスクレイピング技術で用意した独自のデータセットを学習に使用できます。
詳しくはこちら:GEMのAI Agencyが生データをインテリジェントなソリューションへと変換し、ビジネスに予測的インサイト、自動化、さらに高度なAIアプリケーションをもたらす方法をご覧ください。
7 – 採用のための履歴書解析
履歴書解析システムは、履歴書のテキストを分析して履歴書を分類します。このプロジェクトでは、履歴書を処理し、スキル、職歴、学歴などの重要な情報を抽出するシステムの構築に取り組みます。
手順
まず、光学文字認識(OCR)ツールを使用して、PDF形式の履歴書からテキストを抽出します。抽出したデータを前処理し、JSON-to-spaCyなどの構造化された形式に変換します。その後、あらかじめ定義したカテゴリに基づいて履歴書を分類するよう、機械学習モデルを学習させます。
活用分野
- 採用システム:履歴書の選考を自動化し、時間を節約します。
- スキルギャップ分析:不足している資格・要件を特定し、必要な人材の採用につなげます。
- 人事ワークフロー:分類された候補者データを活用して、採用プロセスを効率化します。
推奨データセット
Kaggleなどのプラットフォームにあるサンプル履歴書や、求人ポータルからスクレイピングしたデータセットを学習に使用できます。
8 – 臨床データを用いた疾患予測
医療分野では、臨床記録を分析することで、患者の状態に関する予測的インサイトを得られます。このプロジェクトでは、NLPを使用して、非構造化医療テキストから症状、リスク因子、考えられる診断を特定します。
手順
まず、電子健康記録(EHR)や非構造化された臨床記録を収集します。前処理技術を適用し、症状、人口統計学的情報、既往歴などの意味のある特徴を抽出します。特定の疾患を示唆するパターンを検出するよう、NLPモデルを学習させます。
活用分野
- 医療機関:医療従事者による疾患の特定を支援します。
- 臨床研究:患者データを分析し、傾向を明らかにします。
- 患者ケアシステム:個別化された治療計画のためのツールを開発します。
推奨データセット
モデルの構築とテストには、MIMIC-IIIなどの臨床データセットや、公開されている健康記録を使用してください。
詳しくはこちら:GEMが高度なレコメンデーションモデルを構築し、ユーザーのニーズを先読みして、予測的インサイトによりエンゲージメントを促進する方法をご覧ください。
中級レベルのNLPプロジェクト
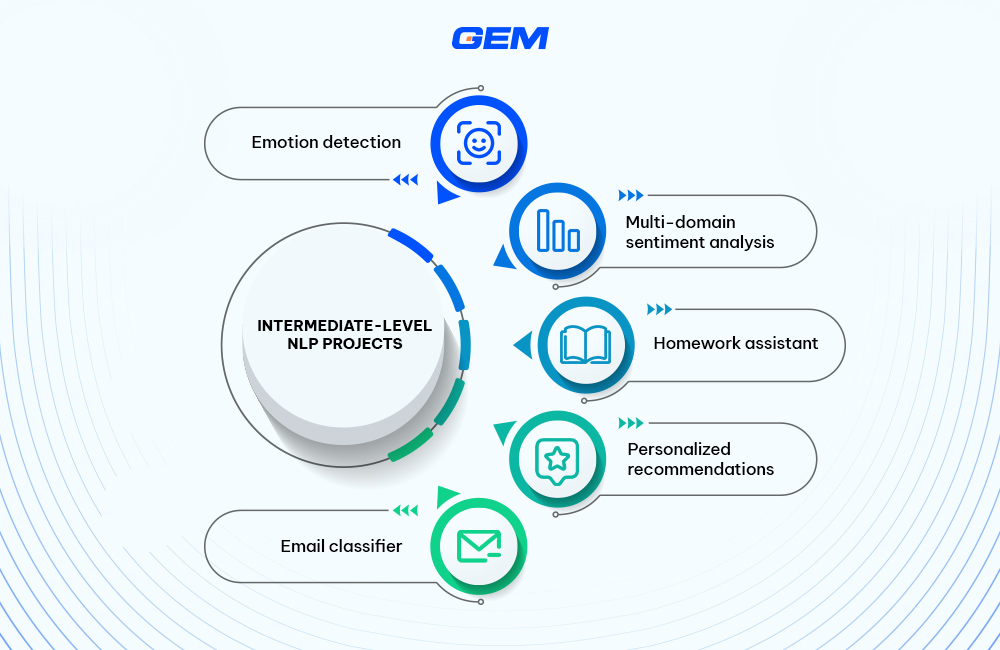
このセクションでは、初級と上級の橋渡しとなるプロジェクトを紹介し、理論的な理解と実践的なスキルの両方を必要とする課題を提供します。
1- 言語識別システムによるテキストの言語検出
このプロジェクトでは、テキストがどの言語で書かれているかを認識できる言語識別システムを作成します。多言語コンテンツを扱うアプリケーションや、テキストの言語的な出自を知りたいユーザーに特に役立ちます。
手順
このプロジェクトでは、テキストサンプルとその言語を対にして収録したLanguage Detectionデータセットを使用します。クリーニング、トークン化、正規化などの前処理を通じて、分析に向けてデータを準備します。その後、Naive Bayes、Random Forestなどのアルゴリズムや深層学習モデルを学習させ、正しい言語を予測できるようにします。
活用分野
- コンテンツ管理システム:多言語コンテンツを効率的に整理します。
- グローバルプラットフォーム: ユーザー向けに言語に基づくパーソナライズを支援します。
- 教育ツール: ユーザーによる新しい言語の識別と学習を支援します。
推奨データセット
Language Detectionデータセットを使用して、システムを実装し、テストできます。
2 – 文脈を考慮するメール分類器
このプロジェクトでは、メールをあらかじめ定義したフォルダ(例:プロモーション、ソーシャル、メイン)に分類するだけでなく、メールの文脈や語調も考慮するメール分類システムの構築に取り組みます。例えば、特別オファーに関するメールに期間限定の特典が含まれていれば、「プロモーション」と「緊急」の両方に分類できます。
プロセス
- 意味を捉えるための特徴抽出に、TF-IDFまたは単語埋め込み(例:Word2VecやFastText)を使用します。
- 重複するカテゴリを効率的に処理できるよう、多ラベル分類モデル(例:ロジスティック回帰、ランダムフォレスト、BERT)を学習させます。
- 感情分析を組み込み、メールの語調と緊急性を検出して、分類にさらなる文脈情報を加えます。
活用分野
- 個人向けメールクライアント:ユーザーの好みに基づいて、受信トレイをより賢く整理します。
- 企業向けメールシステム:緊急性と関連性に基づいてメールに優先順位を付けます。
- スパム検出:感情と文脈の評価を組み込み、スパムフィルタを強化します。
推奨データセット
Enron Email Datasetなどの公開データセット、またはメールスクレイピングツールで収集した独自のデータセットを使用します(プライバシー関連の規定を遵守してください)。
3- 音声からの感情検出
このプロジェクトでは、録音された音声から感情を検出する方法を探ります。声の特徴を分析することで、喜び、悲しみ、怒り、落ち着きなどの感情を識別し、感情を認識できるアプリケーションの開発を支援します。
プロセス
感情別に分類された音声クリップを含むRAVDESSデータセットを使用し、音声ファイルを前処理して、声の高さ、声色、強さなどの特徴を抽出します。サポートベクターマシン(SVM)、ランダムフォレスト、ニューラルネットワークなどのモデルを学習させ、これらの特徴に基づいて感情を分類します。
活用分野
- カスタマーサービス:会話中の顧客の感情を検出することで、対応を改善します。
- メンタルヘルスツール:治療を目的として感情の状態をモニタリングします。
- 対話型音声アシスタント:より直感的で共感的なやり取りを実現します。
推奨データセット
RAVDESSデータセットは、特徴抽出と分類に活用できる、多様性に富んだ難度の高いデータを提供します。
かつてないスピードでアイデアを実現
当社のアジャイルソリューションは、ワークフローを効率化し、市場投入までの期間を短縮することで、革新的な製品やサービスを迅速かつ自信を持って送り出せるよう支援します。
4- 視覚情報をテキストで説明する画像キャプション生成システム
このプロジェクトでは、画像処理とNLPを組み合わせ、画像に対する正確な説明文を生成するシステムを構築します。視覚情報とテキスト情報の間を橋渡しするため、特に視覚障害のあるユーザーに役立ちます。
プロセス
このシステムは画像処理技術を使用して、画像内の物体にラベルを付けます。その後、NLPモデルを使用して、これらのラベルを意味のある文章に変換します。画像のラベル付けに用いるCNN(畳み込みニューラルネットワーク)や、テキスト生成に用いるLSTMなどのディープラーニングアーキテクチャが、このプロジェクトの基盤となります。
活用分野
- アクセシビリティツール:視覚障害のあるユーザーが視覚コンテンツを理解できるよう支援します。
- 電子商取引:画像に対する商品説明を自動生成します。
- コンテンツ制作:メディア内の視覚資料を説明する作業を自動化します。
推奨データセット
Google ResearchのImage-Caption-Quality Datasetは、このプロジェクトの実装に最適です。
5- 複数ドメイン対応の感情分析ツール
このプロジェクトでは、商品レビュー、映画レビュー、飲食店へのフィードバックなど、複数のドメインに適応できる感情分析システムを構築します。従来の感情分類器は、ドメイン固有の言語表現の処理に苦労することが多く、このツールはその限界の解消を目指します。
プロセス
- BERTやRoBERTaなどのTransformerモデルを用いたドメイン適応型の事前学習から始めます。異なるドメインのデータセットでモデルをファインチューニングし、適応性を高めます。
- マルチタスク学習によってシステムを学習させ、ドメイン固有の用語やカテゴリ間の感情表現の違いに対応します。
- 感情の傾向と主要なインサイトを提示するための可視化ツールを組み込みます。
活用分野
- 市場インサイト:さまざまな業界の感情の傾向を分析します。
- ブランド管理:複数の製品ラインにわたって顧客の感情を追跡します。
- デジタルマーケティング:ドメイン固有のフィードバックに基づいてキャンペーンを調整します。
推奨データセット
IMDbのレビュー(映画ドメイン)、Amazonの商品レビュー(電子商取引ドメイン)、Yelpのレビュー(飲食店ドメイン)などのデータセットを組み合わせて学習に使用します。
詳しくはこちら:GEMのデータウェアハウス & データレイクサービスが、データパイプライン、移行、統合を効率化し、円滑な分析と運用を実現する方法をご覧ください。
6 – 宿題支援システムによる学習の簡素化
このプロジェクトでは、学生の宿題を支援するNLPベースのアプリケーションの作成に重点を置きます。学習コンテンツを処理して、質問に対して意味のある適切な回答を提供します。
プロセス
このシステムは、NCERTのPDFや同様の資料などの教育用データセットを学習に使用します。テキストを前処理して関連情報を抽出し、それをユーザーの質問への回答に活用します。機械学習モデルを用いて、質問と最も適切な回答を対応付けます。
活用分野
- 教育ツール:複雑な学術的概念を学生にわかりやすく説明します。
- 保護者支援:保護者が子どもの宿題を正確に指導できるよう支援します。
- Eラーニングプラットフォーム:質問を即座に解決することで学習体験を向上させます。
推奨データセット
NCERTが提供するものなど、無料で利用できる教育用PDFは、実装に活用できる信頼性の高い資料です。
7 – 会議のアクションアイテム自動追跡ツール
このプロジェクトは、会議の文字起こしからアクションアイテムを抽出し、追跡することに重点を置いています。このツールは、会議中に言及された決定事項、担当業務、期限を特定し、参加者に体系的な要約を提供します。
手順
- 音声認識ツール(Google Speech-to-TextやWhisperなど)を使用して、音声をテキストに変換します。
- 係り受け解析と意味役割ラベリングを使用して、主要なエンティティと関係(誰がどのタスクを担当するかなど)を特定します。
- 文を「決定事項」「アクションアイテム」「議論のポイント」などのカテゴリに分類するようモデルを学習させます。
- タスク管理APIを統合し、抽出したアクションアイテムに基づいてタスクを自動的に作成し、割り当てます。
活用分野
- 企業のチーム:会議後のフォローアップを自動化し、責任の履行を促進します。
- プロジェクト管理:担当業務と期限をより明確にします。
- リモートワークプラットフォーム:分散したチームに体系的な要約を提供します。
推奨データセット
AMI Meeting Corpusなどのデータセットを使用するか、組織の録音から独自の会議文字起こしを作成します。
8 – 情報検索を効率化するPDF質問応答システム
研究論文やマニュアルのような長い文書を読み進めるのは、手間がかかることがあります。このプロジェクトでは、ユーザーが質問を入力し、PDFの内容から直接回答を得られるシステムを開発します。
手順
このシステムは、分析のために文書を小さな単位に分割し、検索ベースの手法で関連する箇所を見つけます。その後、言語モデルが正確な回答を生成します。Hugging Face transformersやGradioインターフェースなどのツールを活用して、アップロードされたPDFをリアルタイムで処理する対話型Q&Aシステムを構築できます。
活用分野
- 研究支援:学術論文内の特定の情報を素早く見つけます。
- 企業向けツール:マニュアルや報告書の内容に簡単にアクセスできるようにし、生産性を向上させます。
- カスタマーサポート:ユーザーが製品ドキュメント内の関連する詳細情報を見つけられるよう支援します。
推奨データセット
研究論文、マニュアル、報告書から作成した独自のデータセットをテストに使用できます。
詳しくはこちら:GEMのNLP・AIチャットボット開発が、複雑なテキストや文書を、学習、会議、情報検索を効率化するインテリジェントで対話型のソリューションへとどのように変えるのかをご覧ください。今すぐその可能性を探ってみましょう!
9 – ユーザー体験をパーソナライズする推薦システム
このプロジェクトは、NLP技術と大規模言語モデル(LLM)を活用した推薦システムの構築に重点を置いています。ユーザーの入力とコンテキストデータに基づいて、パーソナライズされた提案を提供します。
手順
このシステムは、従来の機械学習手法と最新のLLMを組み合わせて推薦を生成します。モデルの温度や出力の長さなどの主要なパラメータを最適化し、提案の精度を高めます。このプロジェクトでは、実際のデータセットを使用してユーザーのやり取りをシミュレーションし、推薦の品質を向上させます。
活用分野
- Eコマース:ユーザーに合わせた商品を提案します。
- コンテンツプラットフォーム:ユーザーの好みに基づいて記事、動画、書籍を推薦します。
- 学習管理システム:ユーザーの活動に基づいてコースや学習教材を提案します。
推奨データセット
Eコマースやユーザーのやり取りに関するデータセットを使用して、システムを開発・評価できます。
上級レベルのNLPプロジェクト
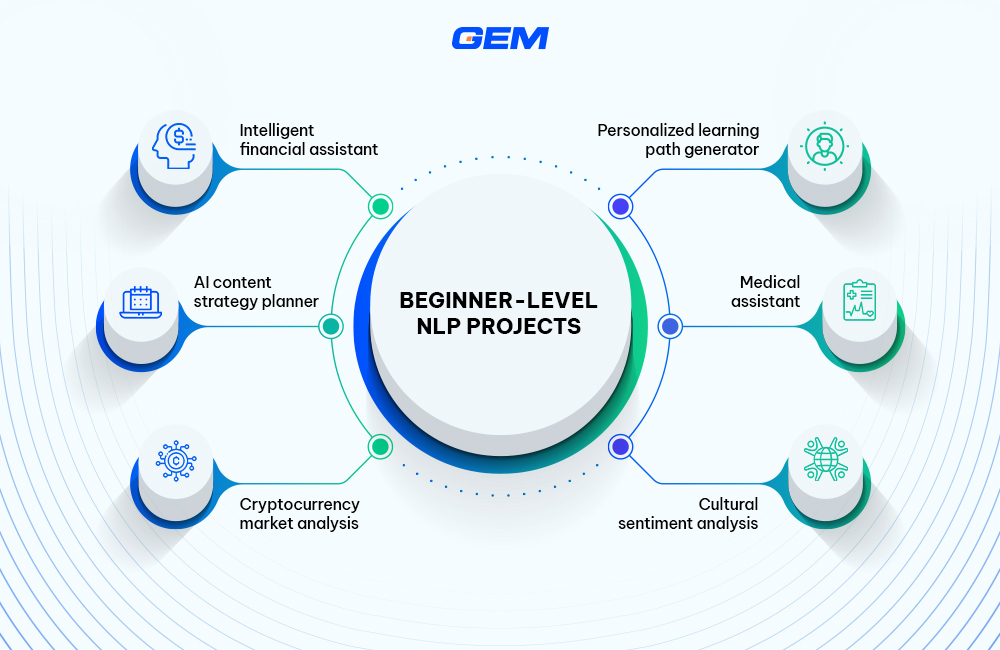
これらのプロジェクトでは、複雑な技術と最先端のツールを活用して業界の課題に取り組み、革新的なソリューションを開発することで、NLPの能力を深く探求します。
1 – リアルタイムのインサイトを提供するインテリジェントな金融アシスタント
このプロジェクトは、行動につながる金融インサイトを提供するマルチエージェントAIアシスタントの作成に重点を置いています。データ取得、トレンド分析、レポート生成を自動化することで、株式取引や投資計画における、より賢明な意思決定を支援します。
プロセス
- Phidataを使用して、株式データ用のyfinanceやWebベースの金融情報検索用のDuckDuckGoなどのAPIを統合します。
- LangChain-GroqやOpenAIモデルなどのツールでワークフローを構築し、トレンドを分析してインサイトを要約します。
- データの取得、分析、取りまとめを担うエージェントでモジュール型アーキテクチャを実装します。
活用分野
- 株式取引プラットフォーム:市場の最新情報とトレンド予測をユーザーに提供します。
- 投資会社:調査プロセスを自動化し、ポートフォリオ管理を最適化します。
- 個人向け資産管理ツール:個人に合わせた市場インサイトを提供します。
データセットの提案
公開されている金融データセットとAPIを使用し、実環境でのデータ取得をシミュレーションします。
2 – AIを活用したコンテンツ戦略プランナー
このプロジェクトは、SEOに最適化されたコンテンツ計画の作成を自動化し、マーケター、ブロガー、デジタルメディアの専門家が、ターゲット層に合わせた成果の高い戦略を策定できるよう支援します。
プロセス
- CrewAIとLlama 3 (70B)を使用して、コンテンツの概要、トピック、キーワードを豊富に含む構成を生成します。
- ターゲット層のペルソナを定義し、キーワード調査とSEO最適化のツールを統合します。
- システムが引用資料や情報源を提案できるようにし、コンテンツの信頼性を確保します。
活用分野
- デジタルマーケティング:トピックの自動推薦によりキャンペーン計画を効率化します。
- コンテンツ制作会社:手作業による調査を減らし、生産性を向上させます。
- Eラーニングプラットフォーム:対象となる学習者のニーズに基づいて、体系的なコースコンテンツを生成します。
データセットの提案
過去のブログデータ、キーワード検索トレンド、SEO分析データを使用してシステムを改善します。
3 – サイバーセキュリティインテリジェンスシステム
このプロジェクトは、脅威の検出と分析を自動化し、サイバーセキュリティのレジリエンスを強化することに重点を置いています。マルチエージェントAIシステムがリアルタイムの脅威を監視し、脆弱性を特定して、緩和策を提案します。
プロセス
- CrewAIとLangChain-Groqを統合し、EXAなどのAPIから得られる脅威データを分析します。
- エージェントを使用してサイバーセキュリティ情報を取得、分類し、優先順位を付けます。
- 脆弱性と推奨される対策を明示した、体系的なレポートを生成します。
活用分野
- セキュリティオペレーションセンター(SOC):脅威の監視と報告を自動化します。
- 企業のITチーム:脆弱性が悪用される前に特定し、対処します。
- サイバーセキュリティコンサルティング会社:詳細な脅威インテリジェンスを顧客に提供します。
データセットの提案
信頼できる情報源の脅威インテリジェンスフィードやリアルタイムAPIを使用し、実際の稼働環境をシミュレーションします。
貴社のビジネスに最適なAIソリューションを見つけましょう
最適なAIの活用方法にお悩みですか?貴社の目標と課題に合わせたソリューションを見つけるお手伝いをいたします。
4 – 構造化された問い合わせに対応するAIカスタマーサポートエージェント
このプロジェクトでは、カスタマーサポートへの問い合わせを正確に処理できる、構造化されたAIエージェントの作成方法を示します。堅牢な検証機能を統合することで正確な応答を確保し、エラーを減らして信頼性を向上させます。
プロセス
- データ検証にはPydanticを、動的な問い合わせ処理モデルの構築にはpydantic-aiを使用します。
- 口座残高の確認やカードの紛失届など、構造化された銀行業務のシナリオでシステムを学習させます。
- 厳密なデータ型と応答形式を設定し、エラーを最小限に抑えてハルシネーションを防ぎます。
活用分野
- 銀行業:人の介入を最小限に抑えながら、日常的な問い合わせを効率的に管理します。
- Eコマース:注文追跡と顧客からの問い合わせへの対応を自動化します。
- 通信業:料金請求やサービス障害などの問題に、構造化された応答で対応します。
データセットの提案
銀行のFAQやカスタマーサポートのログなど、分野固有のデータを使用してモデルを学習させます。
5 – 医療アシスタント:個人に合わせた健康インサイト
このプロジェクトでは、リアルタイムの健康データを分析し、個人に合わせた推奨事項を提供できるAI医療アシスタントを作成します。
プロセス
- CrewAIおよびLangChain-GroqをRapidAPIなどのAPIと組み合わせ、血糖値などの健康指標を取得します。
- データ取得と健康分析のためのタスク駆動型エージェントを設計します。
- ユーザーデータと医療ガイドラインに基づいた推奨事項を提供するよう、システムを学習させます。
活用分野
- 医療機関:遠隔モニタリングと個人に合わせたケアプランを支援します。
- 患者向けアプリ:糖尿病などの慢性疾患を管理するためのインサイトを提供します。
- フィットネスプラットフォーム:リアルタイムの指標に基づき、個人に合わせた健康上のヒントを提供します。
データセットの提案
匿名化された臨床データや健康モニタリングのデータセットを学習とテストに使用します。
詳しくはこちら:GEMのData Platform Transformationで、データの移行とエンジニアリングをシームレスに実施し、企業システムの効率性、拡張性、信頼性を確保しましょう。
6 – 大規模言語モデル(LLM)を活用したチャットボット
このプロジェクトでは、さまざまなプラットフォームで対話体験を提供できるAIチャットボットの構築を探究します。LLMの能力を活用し、多様なユーザーの問い合わせに効果的に対応することに重点を置いています。
プロセス
- 対話機能を実現するためにMistral-7Bモデルを実装します。
- カスタマーサポートの各種場面、FAQ、一般的な問い合わせに対応できるよう、分野固有のデータでチャットボットを学習させます。
- 文脈理解と動的な応答生成に向けてシステムを最適化します。
活用分野
- 電子商取引:購入前後の問い合わせにスムーズに対応します。
- バーチャルアシスタント:パーソナライズされた提案やリマインダーを提供します。
- カスタマーサービス:日常的な問い合わせに対応し、サービス業務の負担を軽減します。
推奨データセット
公開されている対話データセットや、分野固有のFAQログを活用します。
7 – 暗号資産市場分析システム
このプロジェクトは、暗号資産の動向をリアルタイムで分析するマルチエージェントシステムの構築に重点を置いています。
プロセス
- オーケストレーションにはLangChain、高速推論にはGroq、ニュース検索にはExaを使用します。
- 専門エージェント間でタスクを分担します。1つのエージェントがユーザーの質問を把握し、ほかのエージェントがコインの動向やニュースを分析し、最後のエージェントが要約をまとめます。
- 暗号資産の動向を解釈し、行動につながるインサイトを提供できるようにモデルを学習させます。
活用分野
- 暗号資産取引プラットフォーム:日々の市場情報と価格動向の予測を提供します。
- 投資会社:暗号資産の調査を自動化し、ポートフォリオ戦略の策定に役立てます。
- 暗号資産愛好家:手軽に利用でき、理解しやすい市場インサイトを提供します。
推奨データセット
CoinMarketCapやBinanceなどのAPIから暗号資産市場データを取得して活用します。
8 – パーソナライズされた学習経路の生成ツール
このプロジェクトは、学生や社会人の目標、スキル、改善が必要な分野に基づいて、パーソナライズされた学習経路を生成するNLP搭載システムの構築に重点を置いています。キャリアの希望や学業成績などのユーザー入力を分析し、一人ひとりに合った講座、学習リソース、スケジュールを提案します。
プロセス
- 意味解析を使用してユーザー入力を処理し、主要な目標や知識の不足を抽出します。
- LLMを実装し、ユーザープロファイルをオンライン講座や教科書などの膨大な学習リソースのデータベースと照合します。
- ユーザーの進捗やフィードバックに応じて学習経路を調整する、適応型の推薦モデルを構築します。
活用分野
- eラーニングプラットフォーム:ユーザーに合わせた講座を提案します。
- 企業研修:組織の要件に基づいて従業員のスキル向上を支援します。
- キャリアカウンセリング:キャリア転換に向けて実行可能な学習経路を提供します。
推奨データセット
Coursera、Udemy、Khan Academyなどのプラットフォームのデータセットを使用して、システムを学習させます。
時は金なり – 時間もコストも無駄にしないために
反復作業に費やす1分1分が、機会の損失につながります。今こそAIを活用し、生産性を高め、リソースを節約して、ビジネスの成長に集中しましょう
9 – AI搭載ポリシーレビューシステム
このプロジェクトでは、法的契約書やコンプライアンスガイドラインなど、長文のポリシー文書のレビューと要約を自動化するシステムを設計します。システムは主要な条項を特定し、潜在的なリスクを強調表示するとともに、意思決定者に簡潔な要約を提供します。
プロセス
- 文書を論理的なセクションに分割して前処理します。
- 固有表現抽出(NER)を使用し、日付、条項、用語などの主要なエンティティを抽出します。
- 要約モデルを適用し、文書を行動につながるインサイトに凝縮します。
- リスク分析モジュールを統合し、曖昧な条項や重要な条項にフラグを付けます。
活用分野
- 法律事務所:契約レビューのプロセスを効率化します。
- コンプライアンスチーム:規制要件への準拠を確保します。
- 全社的リスク管理:取引先との契約やポリシーに潜むリスクを特定します。
推奨データセット
LexNLPやその他の法律文書リポジトリで入手できる、法的契約書や公共政策文書のデータセットを活用します。
10 – ニュース記事からのイベント抽出
このプロジェクトは、ニュース記事からイベントを抽出して分類するシステムの構築を目指します。システムは、イベントの種類(政治、経済、自然災害など)、主要な関係者、関連する詳細情報を特定します。
プロセス
- NERと係り受け解析を使用し、エンティティとその関係を抽出します。
- イベントを事前に定義された種類に分類するための分類モデルを学習させます。
- イベントを時系列で表示するタイムライン生成機能を実装します。
活用分野
- メディアモニタリング:世界の出来事をリアルタイムで追跡します。
- 危機管理:自然災害などの事象を特定し、対応します。
- 市場分析:金融市場に影響を及ぼす経済的・政治的な出来事を監視します。
推奨データセット
GDELTやEventRegistryなどのニュースデータセットを使用して、モデルを学習させます。
詳しくはこちら:GEMの生成AIソリューションを活用し、アイデアをインテリジェントなコンテンツへと変換し、クリエイティブなワークフローを自動化して、ビジネスに次の段階のイノベーションをもたらしましょう。
11 – AI搭載会議要約ツール
このプロジェクトでは、会議の文字起こしから簡潔な要約を生成するツールを構築します。アクションアイテム、決定事項、主な議論のポイントを特定し、チームが認識を共有して生産性を維持できるよう支援します。
プロセス
- 音声認識による文字起こしツールを使用して、録音音声をテキストに変換します。
- トピックモデリングを適用して、主なテーマや議論のポイントを特定します。
- 要約モデルを使用して文字起こしの内容を構造化された形式にまとめ、決定事項とアクションアイテムを強調します。
活用分野
- 企業内のチーム:会議後のフォローアップとタスクの割り当てを効率化します。
- プロジェクト管理ツール:要約をタスク追跡システムに統合します。
- リモートワークプラットフォーム:議論を文書化することで、分散したチームを支援します。
推奨データセット
AMI Corpusなどの会議データセットや、組織の録音から作成したカスタムデータセットを使用します。
12 – グローバルブランドのための文化的感情分析
このプロジェクトでは、顧客のフィードバックやオンラインコンテンツを分析し、文化的背景に基づく感情を把握します。グローバルブランドが、自社の製品やキャンペーンが各地域でどのように受け止められているかを理解できるよう支援し、より地域に即した効果的な戦略を可能にします。
プロセス
- Twitter、Reddit、製品レビューサイトなどのプラットフォームからユーザー生成コンテンツを収集します。
- 地域の方言や文化的背景に合わせてファインチューニングされた感情分析モデルを使用します。
- ジオタグを付与して、感情を特定の場所に対応付けます。
活用分野
- マーケティングチーム:地域の嗜好に合うようにキャンペーンを調整します。
- ブランド評判管理:さまざまな市場における世間の認識を監視します。
- 製品開発:地域ごとのフィードバックに基づいて機能やデザインを調整します。
推奨データセット
ソーシャルメディアプラットフォームや製品レビューサイトのデータセットを使用し、多言語データや位置情報タグ付きデータを重視します。
円滑なデジタルトランスフォーメーションで未来に備えましょう
業務を中断させないモダナイゼーションサービスで、ビジネスの成長を加速しましょう。既存インフラの価値を最大化し、プロセスを効率化して、コストを削減します。
NLPプロジェクトの選定と実装に向けた戦略的アプローチ
自然言語処理(NLP)は、業界を問わず、業務上の課題への対応、ワークフローの自動化、イノベーションの推進に、比類のない機会をもたらします。ただし、適切なNLPプロジェクトを選定し、効果的に実行するには、慎重な計画と組織の優先事項との整合性が必要です。
考慮すべき基本要素
NLPの取り組みにリソースを投入する前に、意思決定の指針とし、プロジェクトの可能性を最大限に引き出すため、いくつかの要素を検討する必要があります。
- 焦点を絞った目標の定義
反復作業の自動化、非構造化データの分析、ユーザーとの対話システムの改善など、プロジェクトで解決する課題を明確に示します。範囲を明確に定義することで、組織の目標との整合性を維持しやすくなります。
- データの準備状況の評価
利用可能なデータが十分で、関連性があり、適切な品質を備えているかを分析します。NLPはデータに大きく依存するため、データの入手可能性や関連性に不足があると、プロジェクトの性能が制限される可能性があります。
- 実現可能性の評価
プロジェクトの技術面および運用面の要件を把握します。これには、タスクの複雑さ、利用可能なインフラ、チームの実行準備状況が含まれます。これらの要素に早い段階で対応することで、実装時の不要な障害を回避しやすくなります。
- ビジネス目標との整合性を優先
プロジェクトは、業務の改善や顧客体験の向上など、組織全体の優先事項を反映する必要があります。この整合性を確保することで、プロジェクトがビジネスに具体的な効果をもたらします。
- 将来の拡張性を考慮
成長や要件の変化に対応できるプロジェクトを選びます。例えば、カスタマーサポート用チャットボットには、時間の経過とともに増加する問い合わせへの対応や、追加のプラットフォームとの統合を可能にする柔軟性が求められます。
NLPプロジェクトの実装プロセス
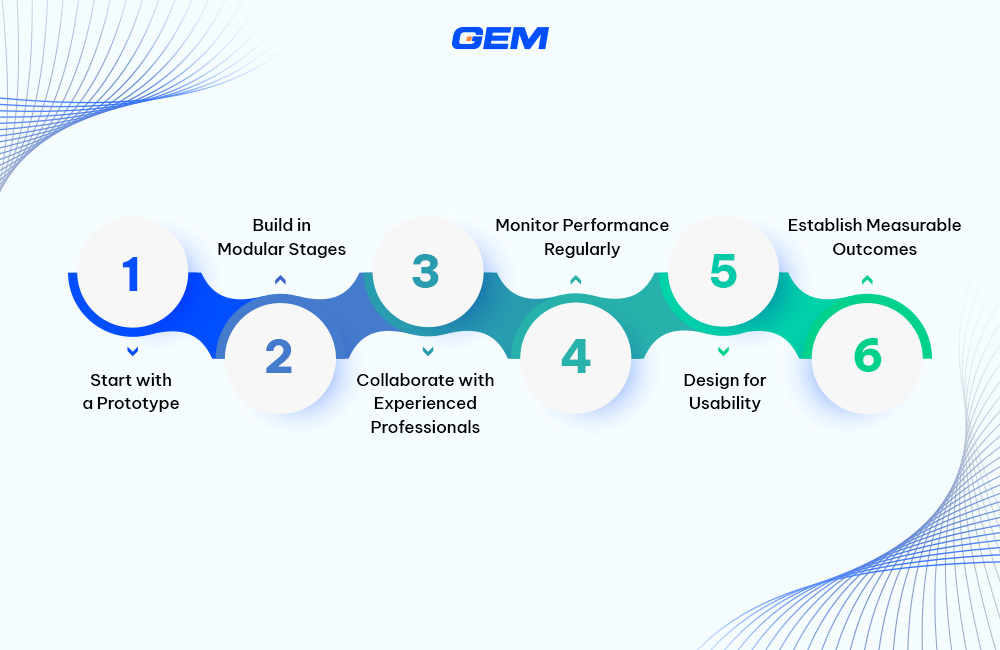
NLPプロジェクトの成功は、明確に定義された実行戦略にかかっています。以下のベストプラクティスが、プロセスの指針となります。
プロトタイプから開始
機能を限定したソリューションから始め、実現可能性と効果を検証します。このアプローチにより、想定される課題について有益な知見が得られ、広範な導入に先立ってプロジェクトを改善できます。
モジュール単位で段階的に構築
まず特定のコンポーネントに焦点を当て、プロジェクトを段階的に実装します。この方法により、チームはシステム全体を妨げることなく、問題に少しずつ対処し、必要に応じて調整できます。
経験豊富な専門家と連携
AIとNLPを専門とするITサービスプロバイダーと提携することで、技術的な複雑さを管理し、実行を効率化できます。こうしたパートナーは、実績のある方法論やフレームワークを提供し、社内チームの負担を軽減しながら円滑な実装を支援します。また、その関与により、ビジネスニーズの変化に応じてソリューションを保守・拡張するための指針も得られます。
性能を定期的に監視
システムの性能を追跡する指標を定義し、状況の変化に応じてシステムを調整します。定期的な評価により、長期にわたって適合性と有効性を維持しやすくなります。
使いやすさを重視した設計
実装時には、エンドユーザーを念頭に置きます。社内ツールでも外部向けソリューションでも、使いやすさは導入・活用を促進し、プロジェクトの価値を最大化します。
測定可能な成果を設定する
効率の向上、コスト削減、ユーザー満足度など、明確な成功指標を定義しましょう。これらの基準は、プロジェクトの効果を評価し、今後の改善の方向性を示すのに役立ちます。
GEM Corporationは、幅広いビジネス課題に対応するカスタムソリューションの開発において、豊富な経験を有しています。自然言語処理(NLP)、ビッグデータ、人工知能(AI)、自動化などの先進技術を活用し、お客様固有のニーズに合わせたシステムを構築・導入しています。当社のポートフォリオには、AIチャットボット、予測分析エンジン、データ変換 プラットフォームなどの革新的なツールが含まれており、いずれも実行につながるインサイトの提供と業務効率の向上を目指しています。GEMは、技術的な専門知識と業界のニーズに対する深い理解を組み合わせることで、実質的な効果をもたらす技術ソリューションを求める組織にとって、信頼できるパートナーとなっています。
結論
注目のNLPプロジェクト35選は、自然言語処理を活用して実際の課題を解決し、イノベーションを推進する方法について、有益な知見を提供します。幅広い難易度を網羅するこれらのプロジェクトは、学習者にも専門家にも適しており、基礎的な手法から高度な実装まで探究する機会を提供します。目的の明確さ、データの準備状況、入念な実行に重点を置くことで、これらのプロジェクトはNLPが現実のニーズにどのように応えられるかを示しています。
NLPプロジェクトが貴社のビジネス課題をどのように解決できるかを探るには、GEMの専門家チームにお問い合わせください。当社のウェブサイトでカスタムソリューションの詳細をご覧いただき、貴社の目標達成をどのように支援できるか、ぜひご相談ください。